Ce rapport présente l'intégralité du travail réalisé dans le cadre des TP 1 à 5 de traitement de données audio-visuelles. Les images et extraits de code utilisés ici sont fournis uniquement à titre d'illustration de mes propos, et ne constituent en aucun cas une solution idéale aux questions posées. Toute utilisation de ces résultats devra donc se faire avec prudence.
Cette première partie se donne pour but d'étudier le processus d'estimation des paramètres d'une courbe de Bézier de degré variable, ainsi que des méthodes permettant le choix de son degré.
Pour des raisons de clarté du code, des choix d'organisation ont été faits afin d'améliorer la structure du projet. Ainsi, la majorité les fonctions fournies avec les sources ont été rassemblées dans la classe Lib.
Voici donc l'API de Lib utilisée dans les fonctions détaillées ci-dessous:
Sealed class Lib:
  Static methods:
    Lib : bernstein(x, d, i) # Polynome de Bernstein (cf documentation)
    Lib : bezier(beta_0, beta, beta_d, x) # Courbe de Bézier (f dans le sujet)
    Lib : gNoise(input, sigma) # Générateur de bruit gaussien additif
    Lib : mean_square_error(input, output) # Erreur quadratique moyenne
Ainsi qu'un exemple d'utilisation :
y = Lib.gNoise(Lib.bezier(beta_0, beta, beta_d, x), sigma);
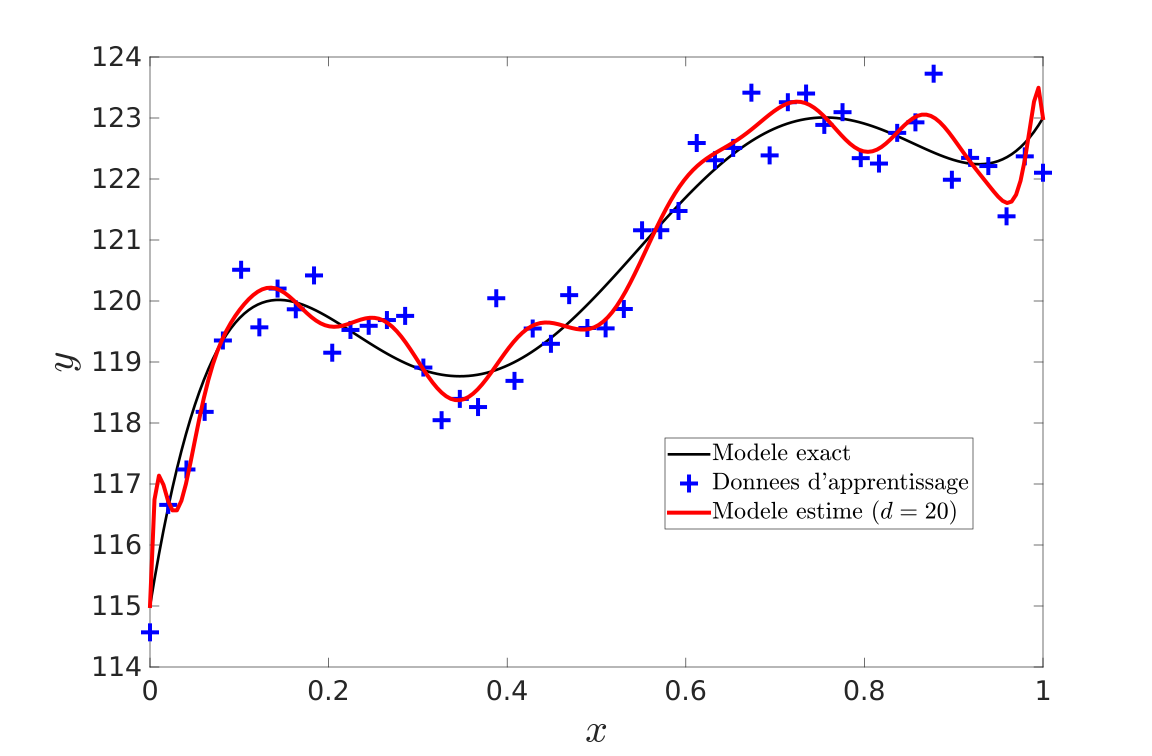
moindres_carresAprès exécution du script exercice_1, on obtient une solution approchée de qui produit la courbe de Bézier suivante, de degré choisi au préalable :
La courbe précédente est très clairement biaisée par un surentrainement. Selon la même logique, pour des valeurs de faibles, on obtient un modèle sous-entrainé, comme le montre le résultat suivant, obtenu pour :
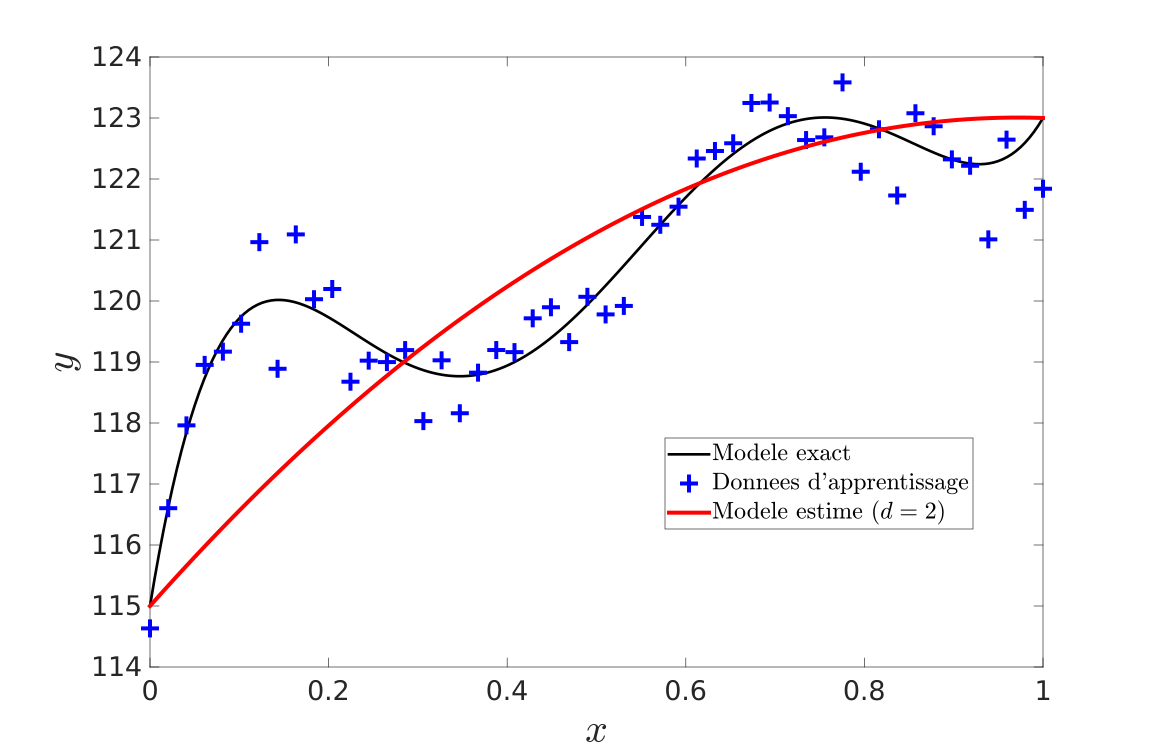
On se rend cependant très rapidement compte de la nécessité de choisir une valeur du degré plus adaptée, comme par exemple , dont la courbe associée est visible ci-dessous :
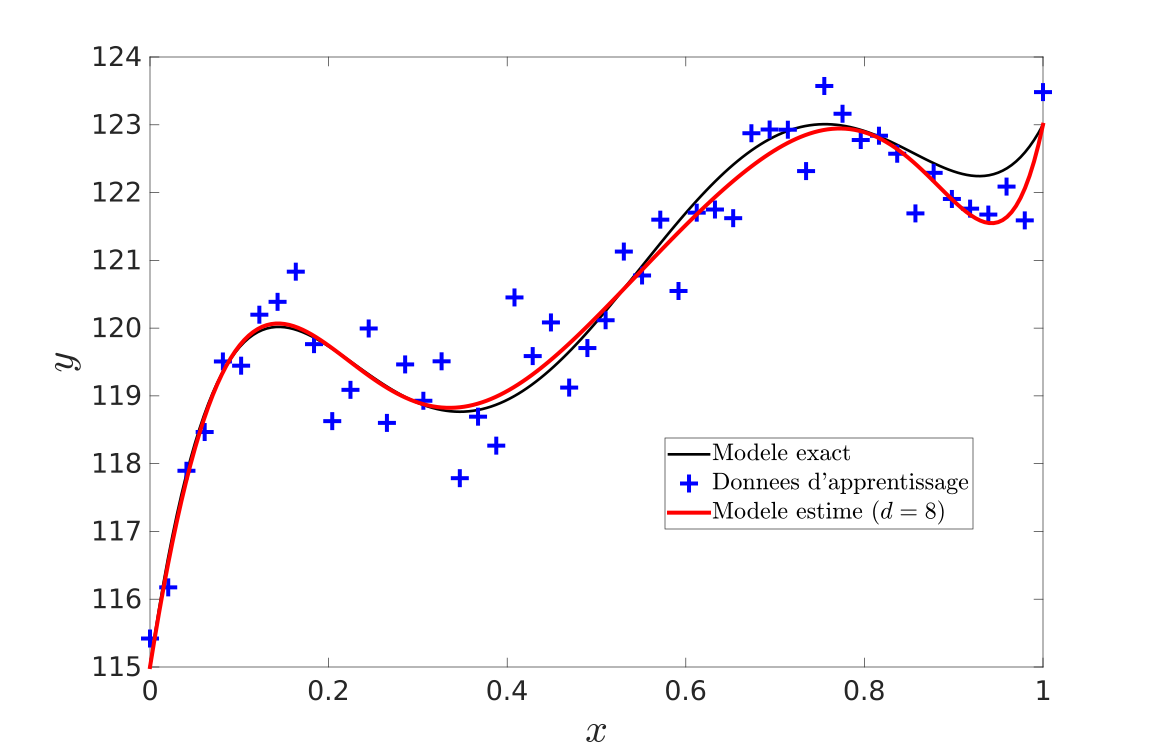
Ce résultat est bien plus satisfaisant, et semble coller bien mieux à la courbe du modèle exact.
erreur_apprentissageL'exécution du script exercice_2 permet de visualiser l'évolution de l'erreur quadratique moyenne d'apprentissage en fonction du degré de la courbe de Bézier.
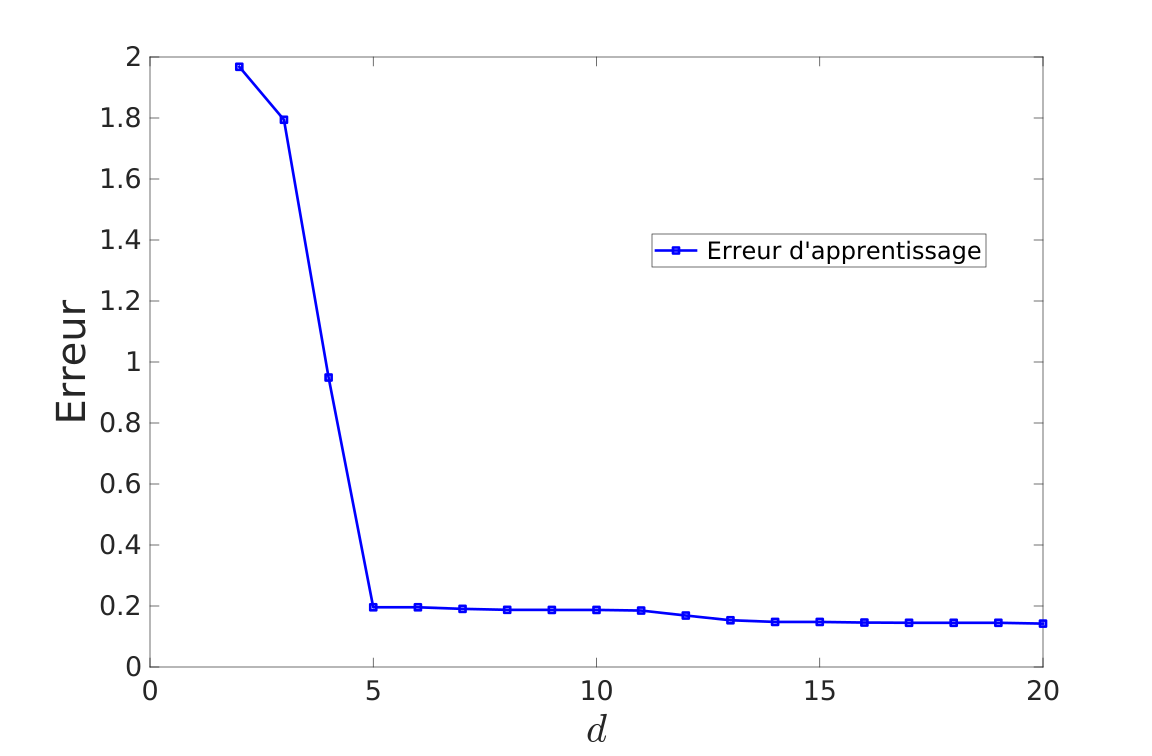
C'est un résultat cohérent, puisque l'erreur décroit en fonction du degré de la courbe de Bézier. Il est cependant pertinent de noter qu'elle varie considérablement moins à partir de .
erreur_generalisation et estimation_d_sigmaLorsque l'on exécute le script exercice_3, faisant appel à erreur_generalisation et estimation_d_sigma, on s'aperçoit que l'erreur de généralisation, contrairement à l'erreur d'apprentissage, a tendance à croitre à partir d'une certaine valeur de , en l'occurence passé le seuil .
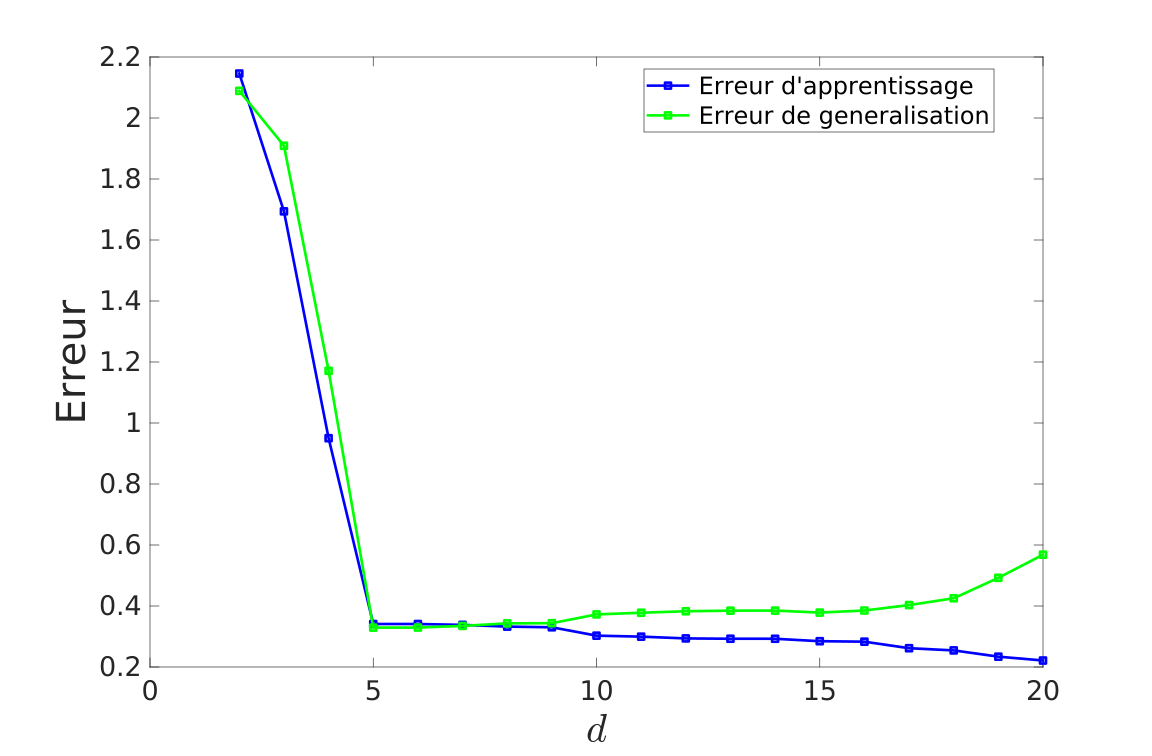
Cette propriété est très avantageuse, puisqu'elle pourait nous permettre d'éviter de surentrainer notre modèle, et ainsi de l'améliorer.
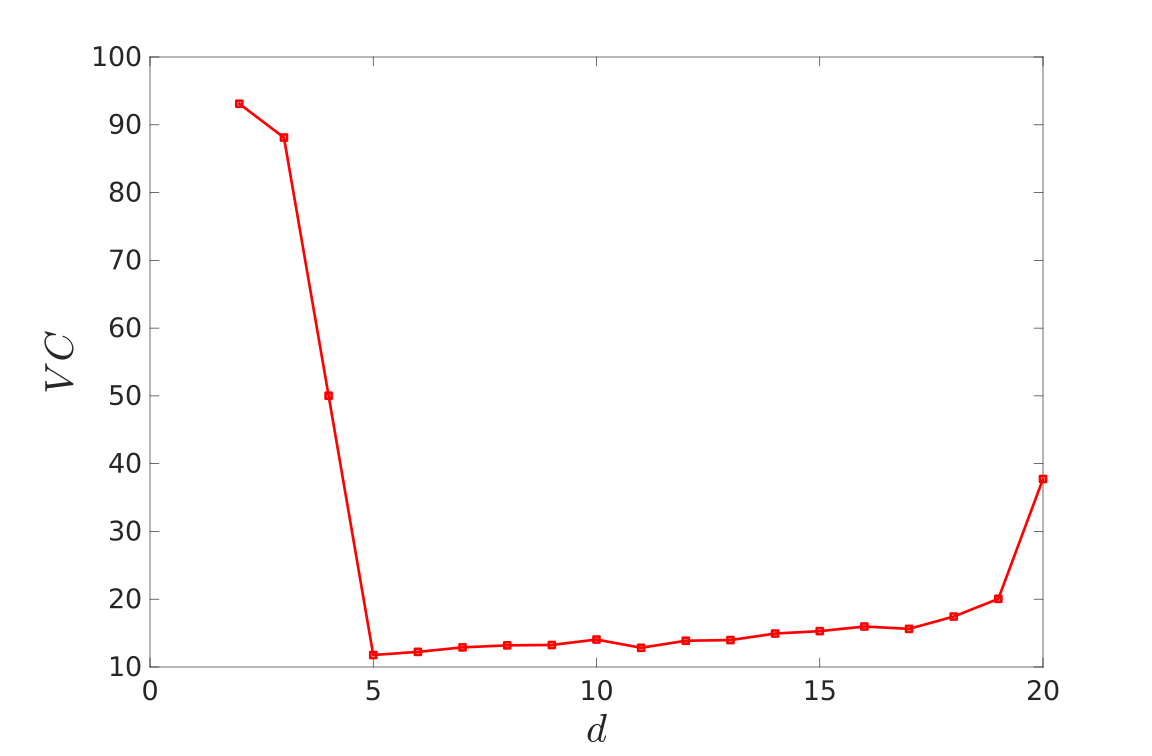
calcul_VC et estimation_d_sigma_bisLe script exercice_4 met en évidence l'utilité de la cross validation approach (approche par validation croisée) leave-one-out pour l'estimation des paramètres d'une courbe de Bézier. En effet, elle permet de clairement distinguer les valeurs de pour lesquelles on peut parler de sur-apprentissage et celle pour lesquelles il s'agit d'une sur-généralisation.
Dans la partie précédente, on avait exploré deux méthodes d'estimation du degré d'une courbe de Bézier, par minimisation de l'erreur de généralisation ou de la validation croisée. On se donne maintenant pour but d'étudier une approche différente, celle de régularisation.
Dans cette partie, ainsi que la majorité des suivantes, on a gardé la structure d'origine, très monolithique et simple, majoritairement par manque de temps. C'est d'ailleurs pour la même raison que les tâches facultatives n'ont pas été abordées.
moindes_carres_ecretesIci, on a fait le choix de ne plus travailler avec mais avec , tq
La fonction moindres_carres_ecretes détermine la valeur de en appliquand le principe de la ridge regression (regression regression). Un hyperparamètre est ajouté afin de pénaliser les écarts les plus importants.
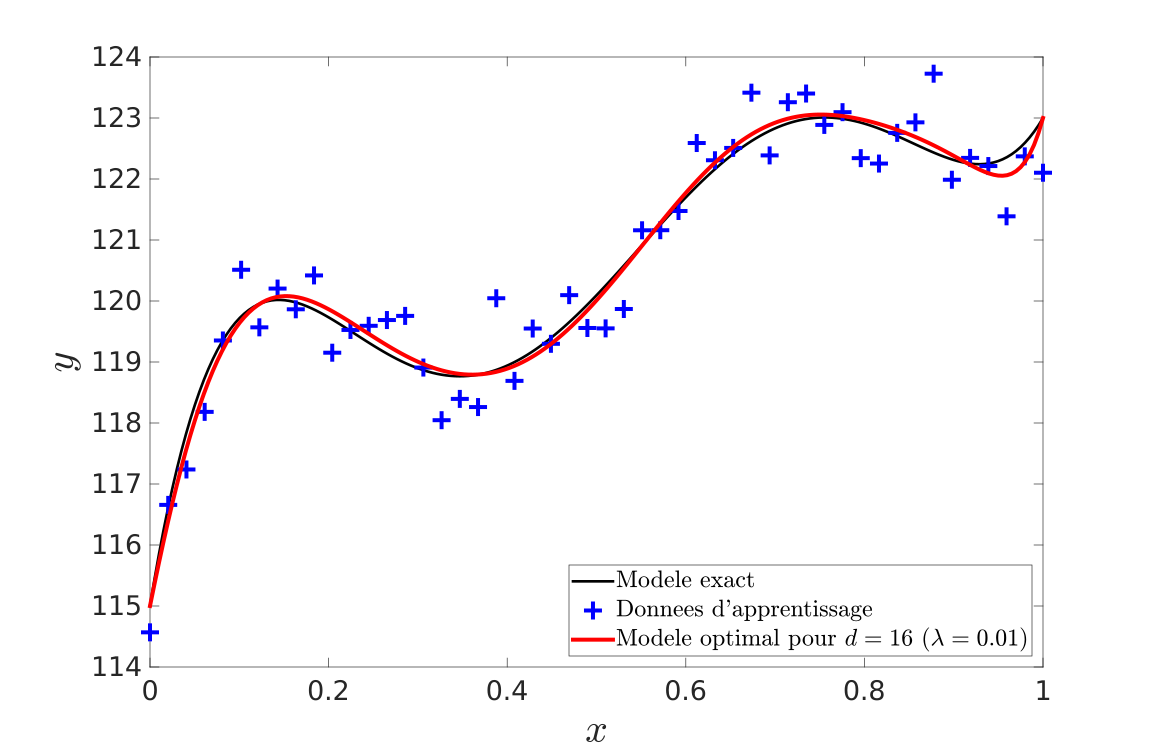
L'exécution suivante du script exercice_1, mettant en oeuvre cette méthode, affiche des résultats bien plus satisfaisant que les précédents pour une valeur de lambda faible (0.05).
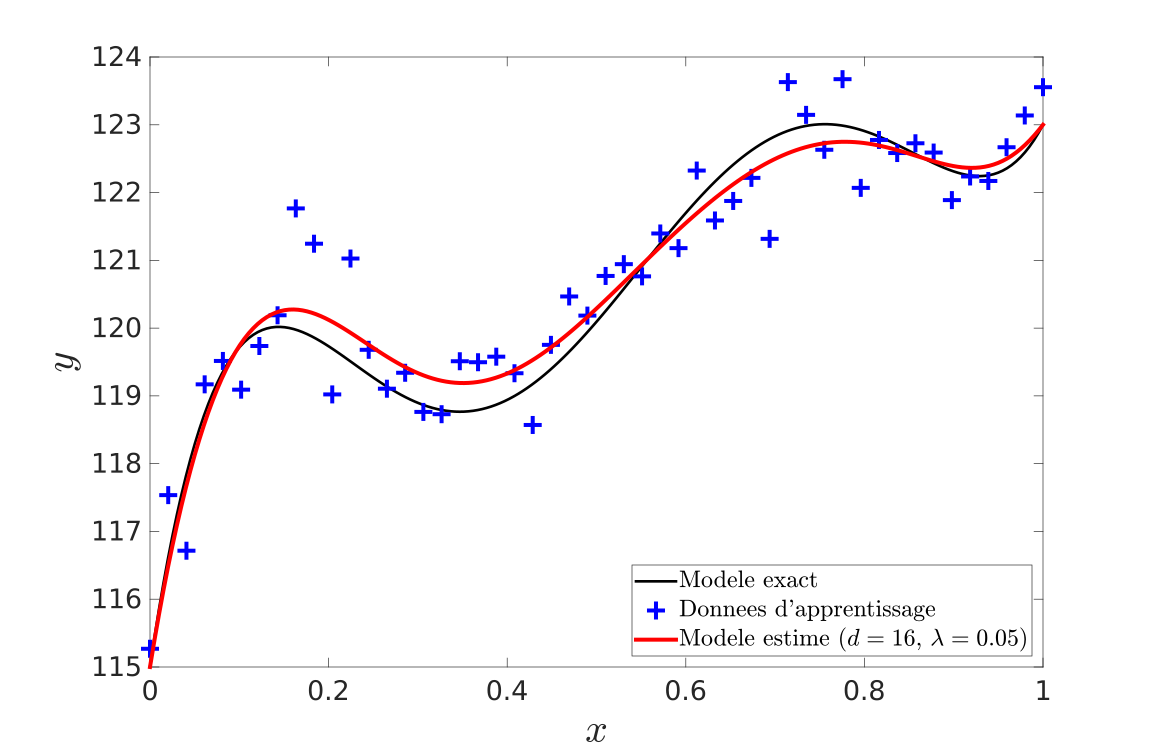
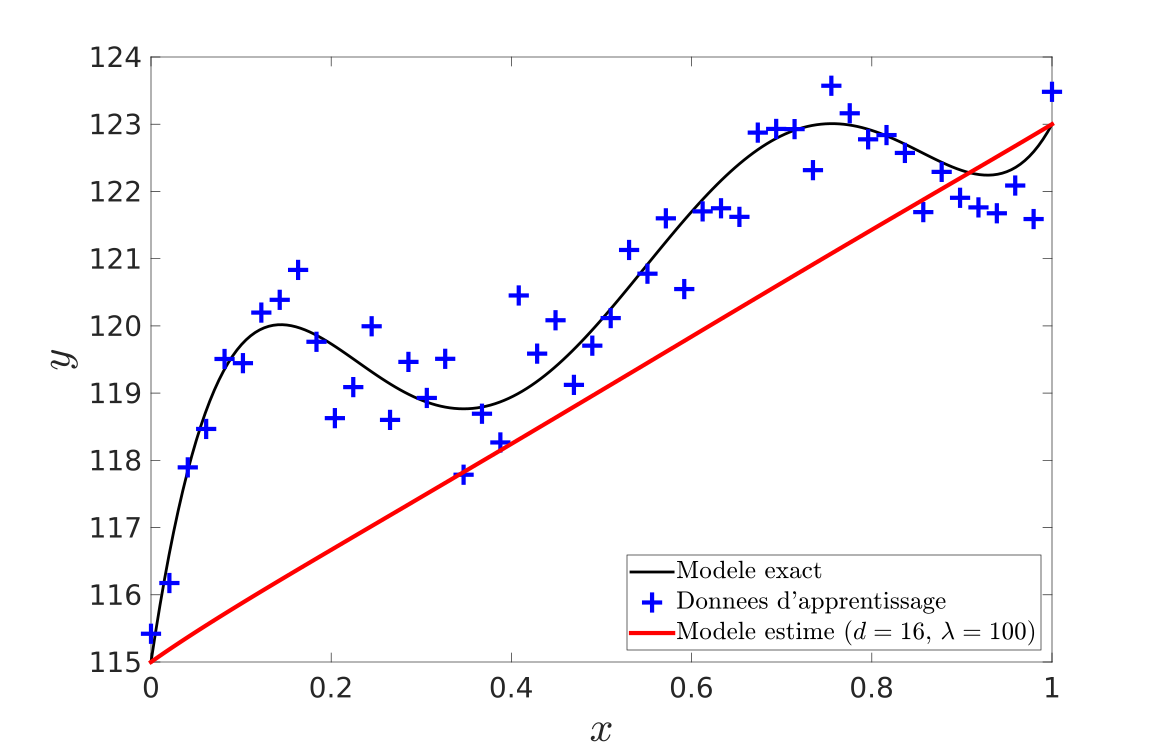
En faisant varier lambda dans l'intervalle , on constate que plus le lambda est grand, plus la courbe obtenue se rapproche d'une droite reliant les points et , comme le montre l'image ci-dessous, prise pour un lambda de .
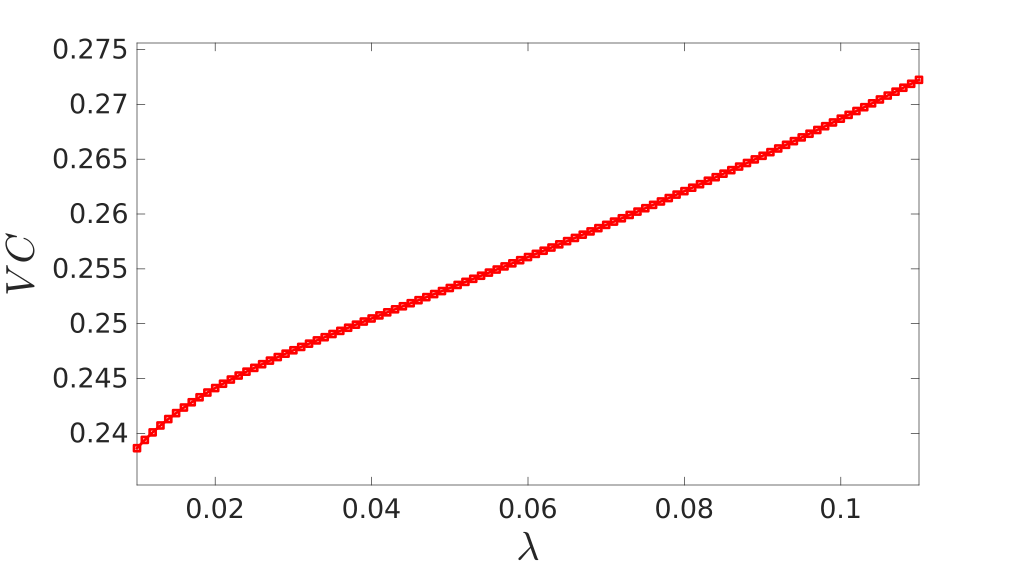
calcul_VC_bis et estimation_lambda_sigmaOn s'intéresse maintenant au calcul de la validation croisée définie, rappelons-le, par l'expression suivante :
que nous appliquons dans la fonction calcul_VC_bis. Quant à estimation_lambda_sigma, elle ne fait que récupérer l'indice et la valeur du minimum de la liste et les renvoyer casiment tel quel :
[m, ind] = min(liste_VC);
lambda_optimal = liste_lambda(ind);
sigma_estime = sqrt(m);
moindres_carres_bis et simulation de la silhouette d'une flamme de bougiePour modéliser l'évolution de la flamme de bougie, on utilise la reformulation du problème proposée par le sujet.
où contient les vecteurs de paramètres et concaténés, soit (on a retiré le par soucis d'optimisation, puisqu'il est égal à ).
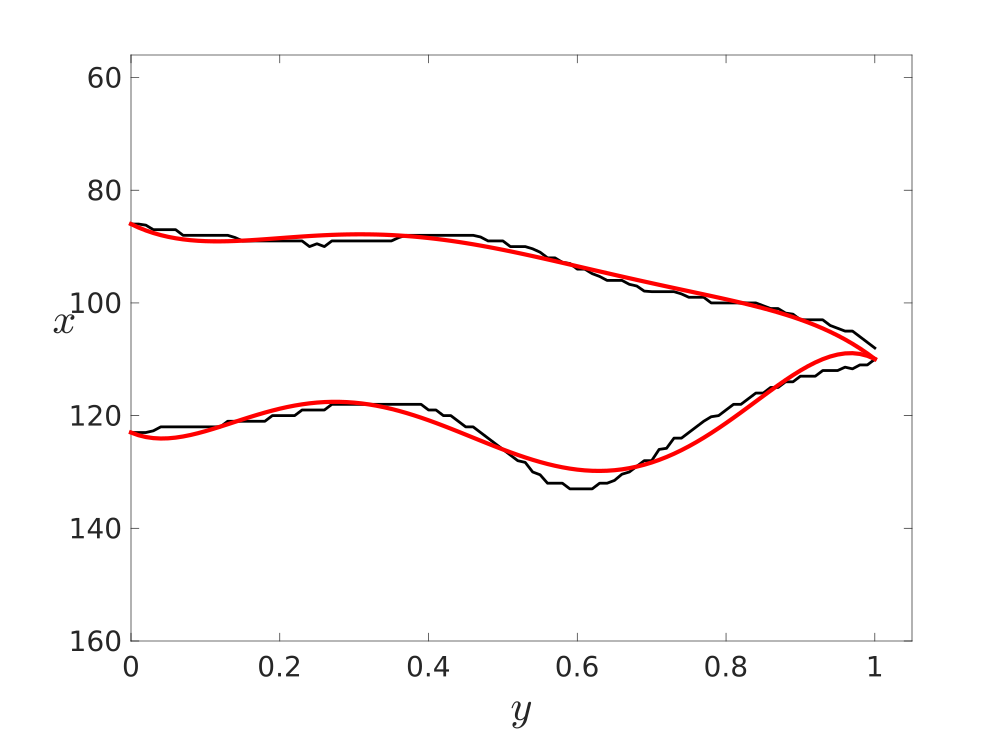
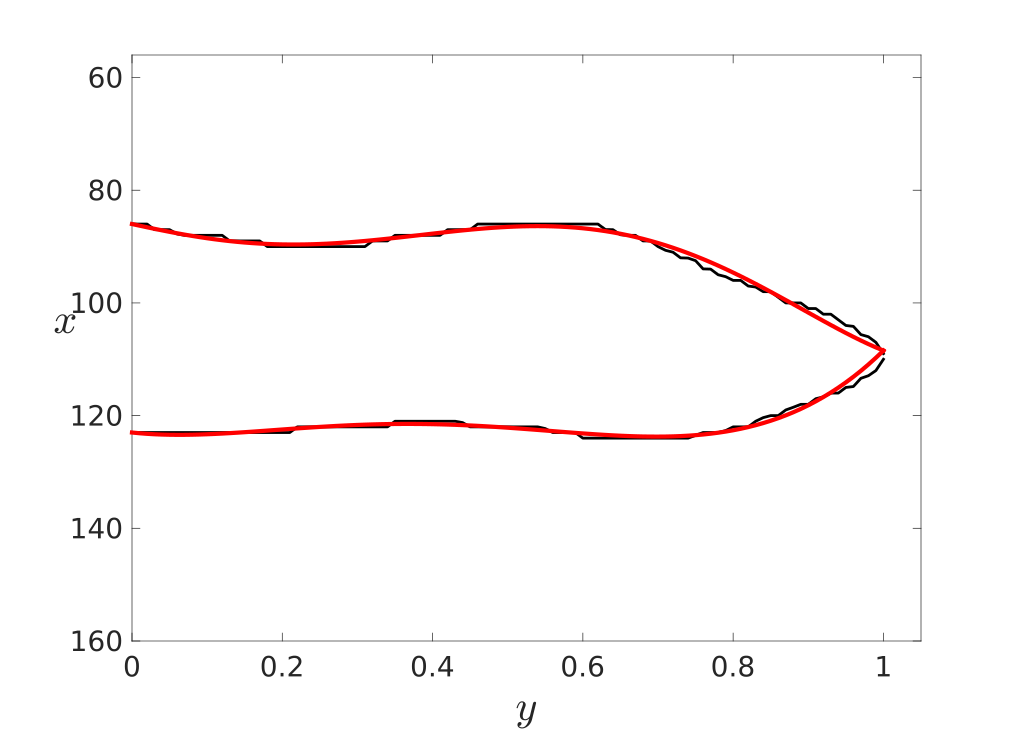
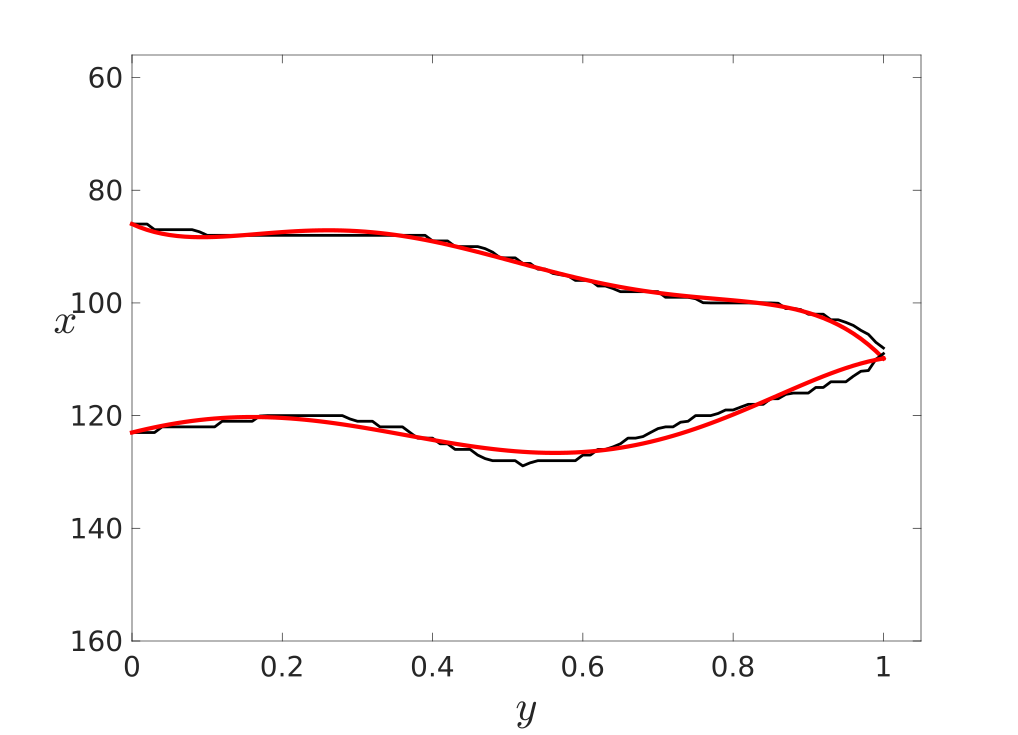
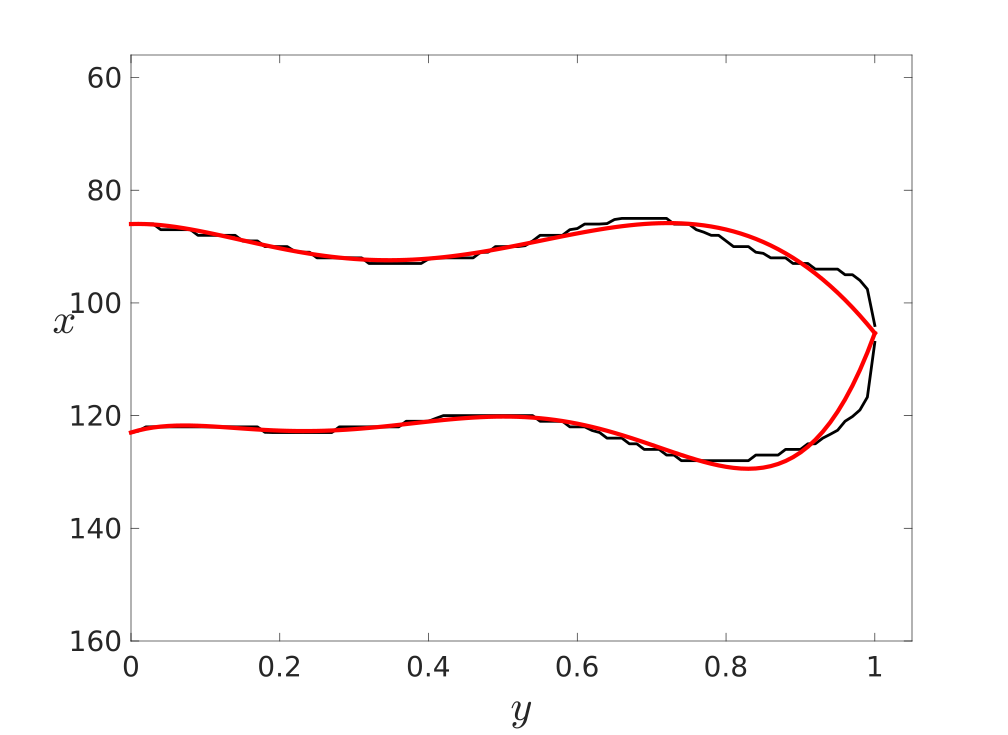
Notre implémentation nous permet ainsi d'obtenir une animation en exécutant le script exercice_2, dont quelques images sont affichées ci-dessous.
 |
 |
 |
 |
estimation_lois_n et simulationLe corps de la fonction estimation_lois_n est assez concis, puisque le calcul des moyennes et des écart types peut se faire à l'aide de fonctions déjà implémentées dans matlab, en l'occurrence, mean et std (standard deviation) :
ecarts_types = std(X);
moyennes = mean(X);
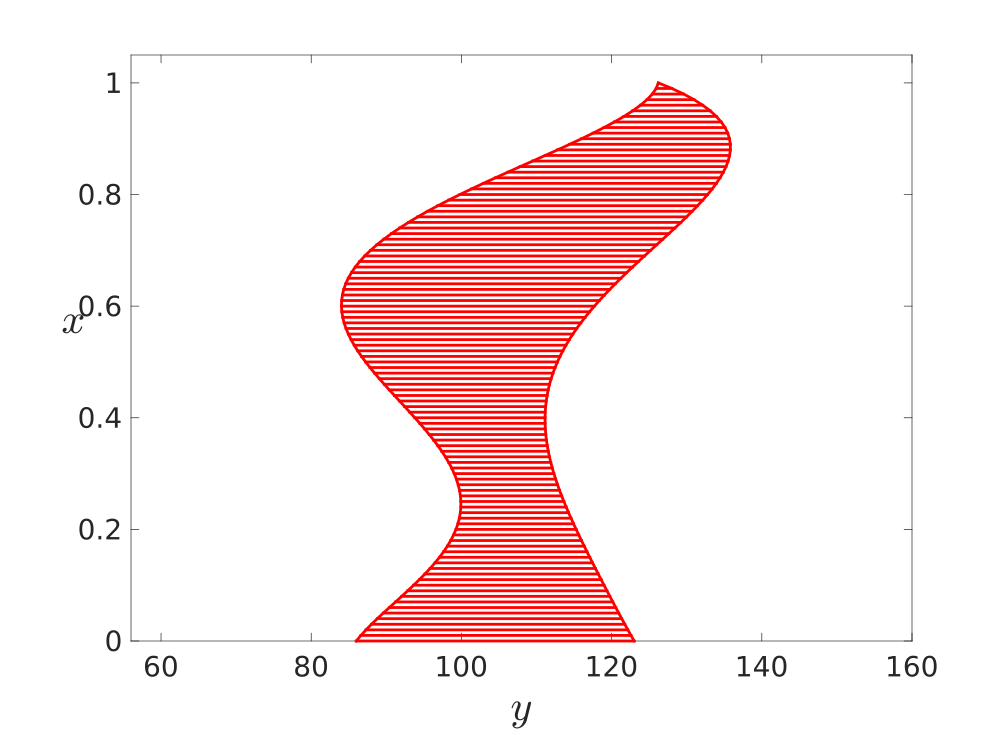
La fonction simulation associe aux vecteurs de paramètres et deux vecteurs de positions des points de la flamme de bougie, côté gauche et côté droit. Le résultat obtenu est, encore une fois, affiché ci-dessous :
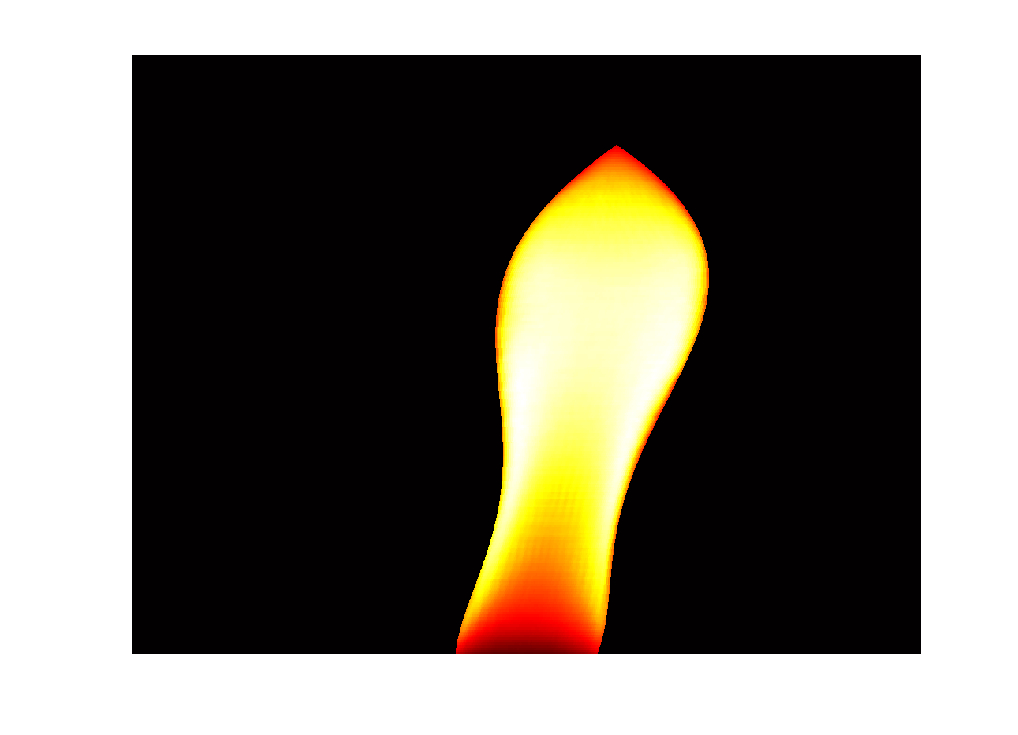
Le script sequence_flammes ajoute de la couleur à l'animation précédente, nous montrant l'intérêt de cette étude, ainsi que les nombreuses applications qu'elle pourrait avoir, dans le monde des jeux video par exemple. Ci-dessous, on peut voir une capture d'écran de l'animation finale :
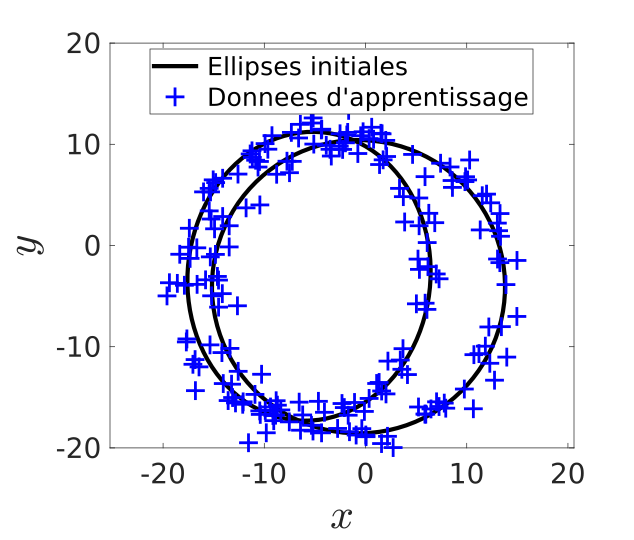
Cette nouvelle partie se donne pour but d'estimer les paramètres d'une ellipse approximant au mieux un ensemble de points. Les ellipses utilisées ici pour la génération du nuage de point (script donnees) sont définies par les cinq paramètres suivants : demi longueur du grand axe, excentricité, abscisse du centre, ordonnée du centre et angle polaire du grand axe.
Dans un premier temps, on se concentre sur l'implémentation plutôt rudimentaire de la méthode d'estimation par le maximum de vraisemblance. On tire des ellipses au hasard et on calcule leur vraisemblance. On choisit alors l'ellipse qui la maximise. Pour rappel, le vraisemblance est obtenue à l'aide de la formule suivante :
avec la densité de probabilité des points
Notre implémentation de max_vraisemblance nous donne ainsi le résultat suivant :
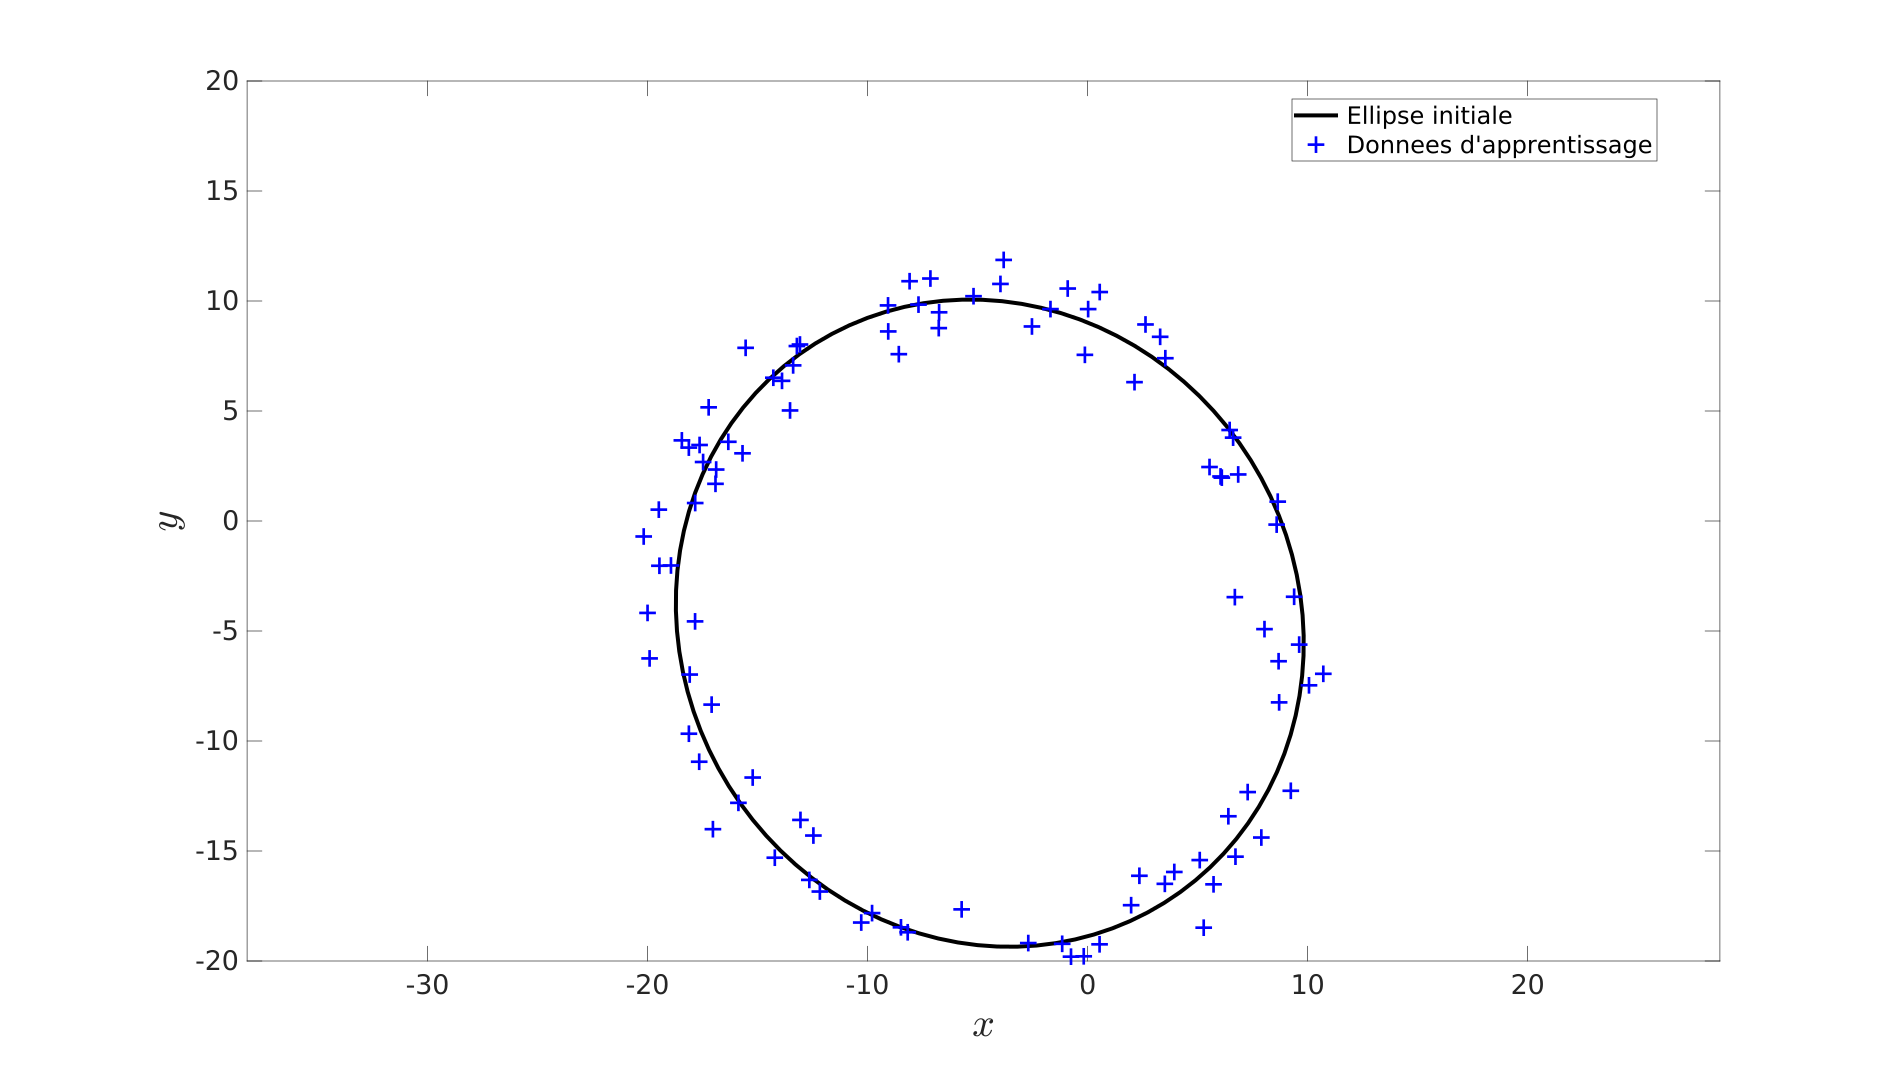 |
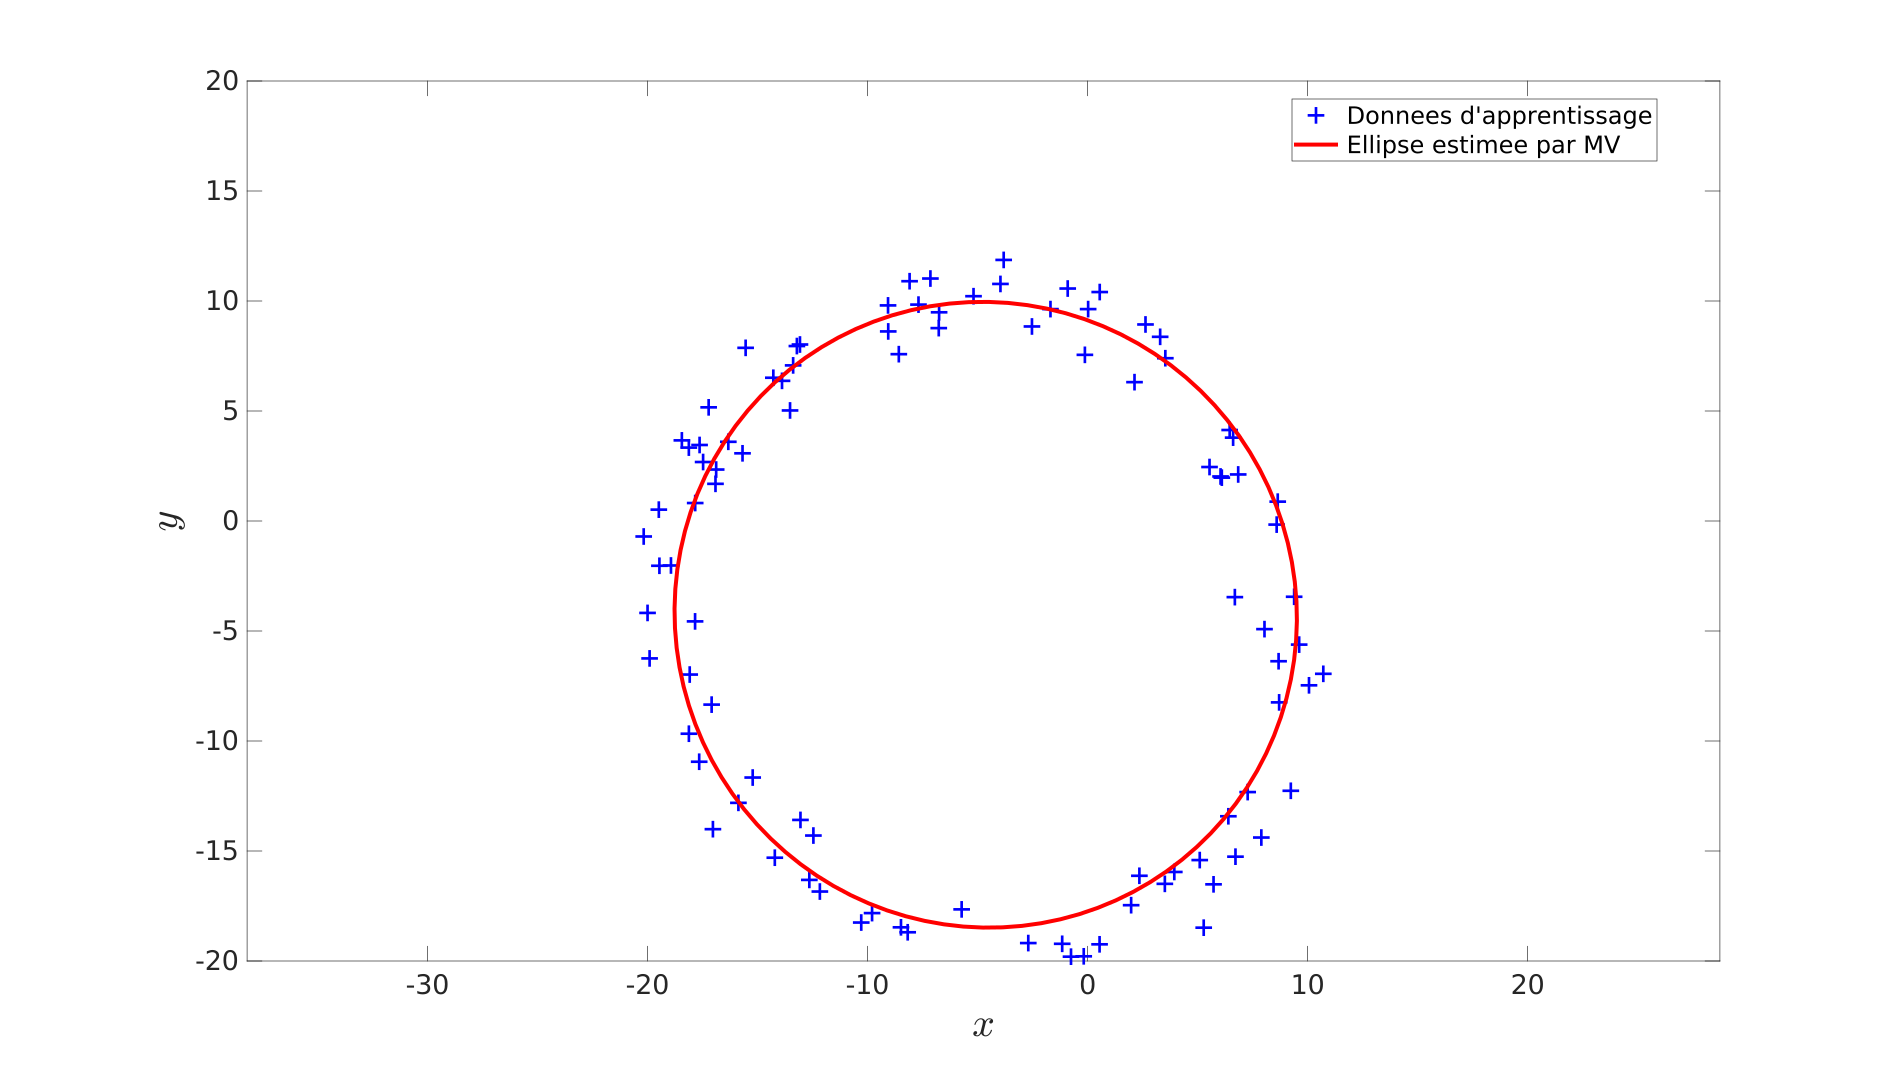 |
|---|---|
| Fig. 13 : Données | Fig. 14 : Estimation obtenue |
C'est une approche satisfaisante, puisque le score retourné est de 0.95 environ, mais elle reste néanmoins assez peu flexible, car moins fiable pour des nuages de points plus dispersés.
On s'intéresse maintenant à une approche mettant en oeuvre une résolution en moindres carrés du système linéaire homogène :
tel que
et ce sextuplet de coefficients vérifie l'équation cartésienne de l'ellipse recherchée :
Il est important de noter que, pour un écart-type nul, le score de l'estimation par résolution du système linéaire est de 1, ce qui est logique puisque les points ne sont pas dispersés et qu'aucun bruit n'est introduit. Ce n'est néanmoins pas le cas de la méthode précédente (maximum de vraisemblance), qui affiche un score de 0.91, ce qui démontre encore une fois son manque de fiabilité.
Pour , voici le résultat obtenu :
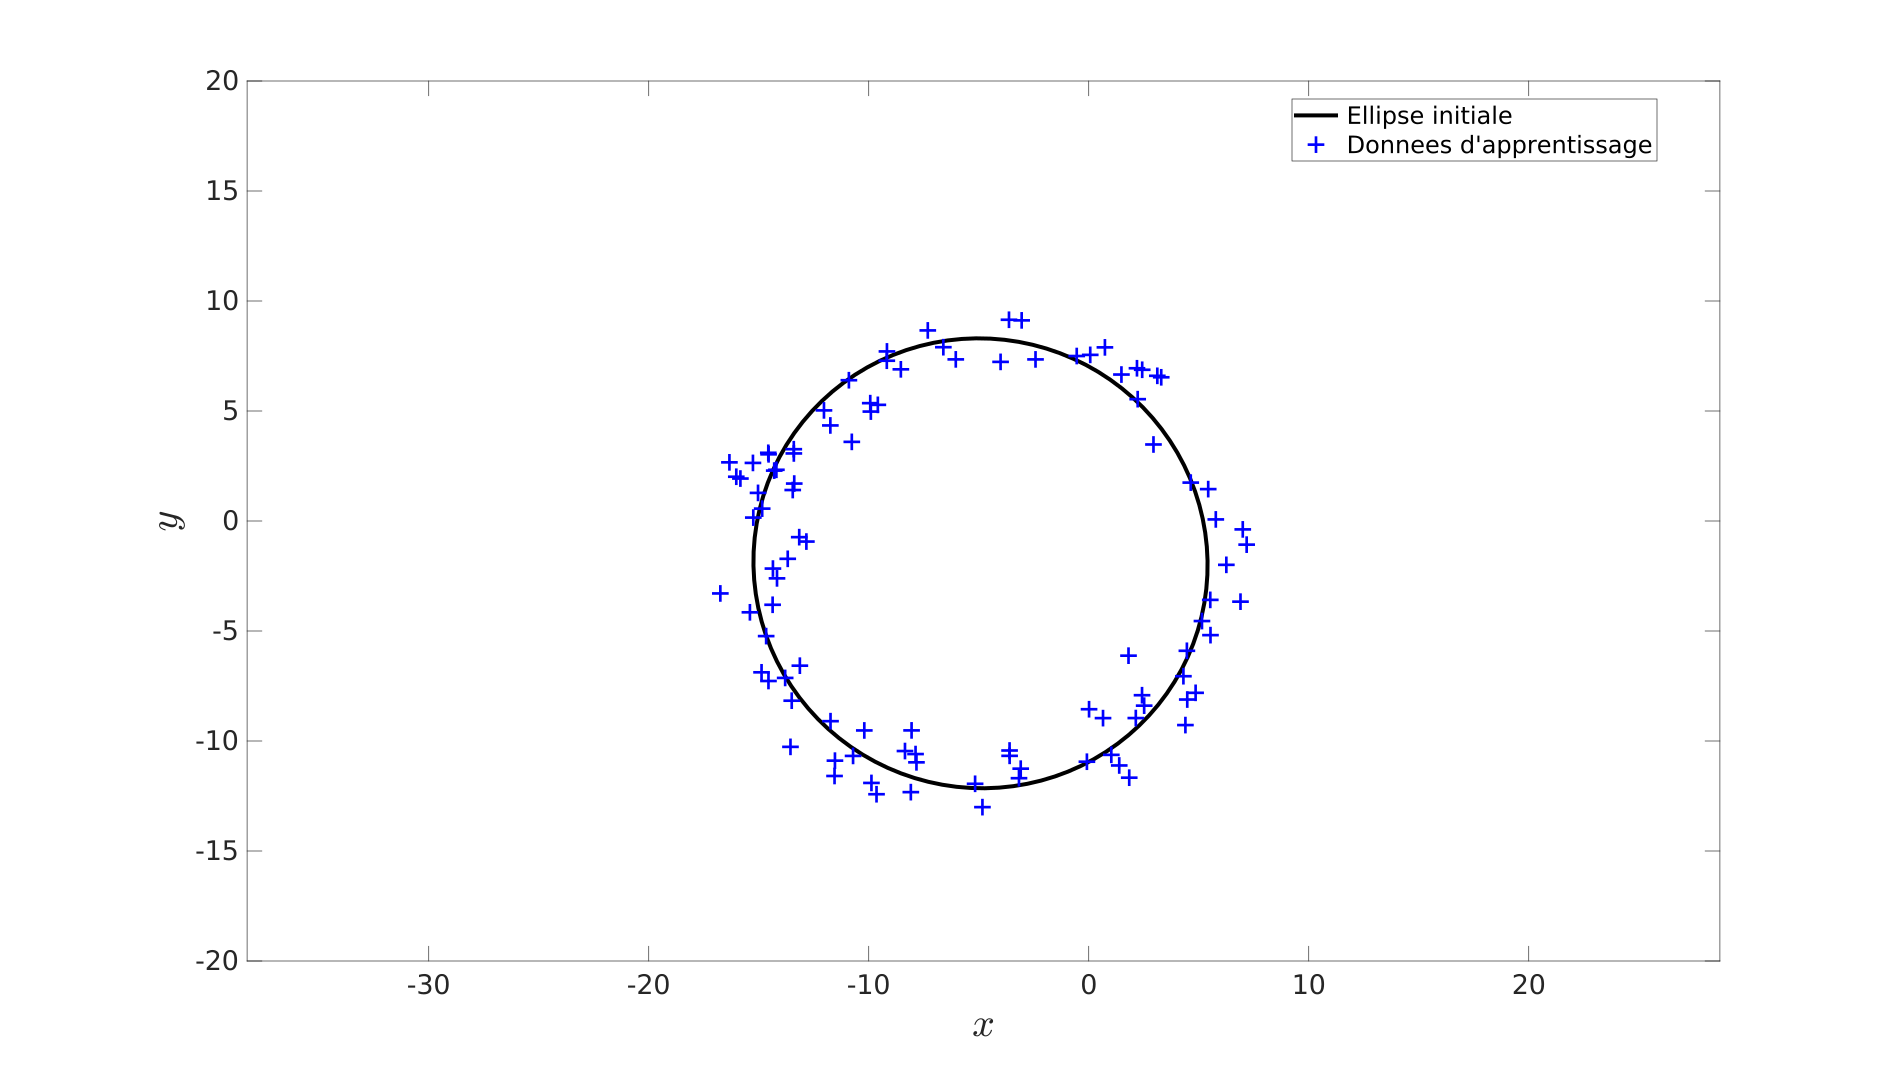 |
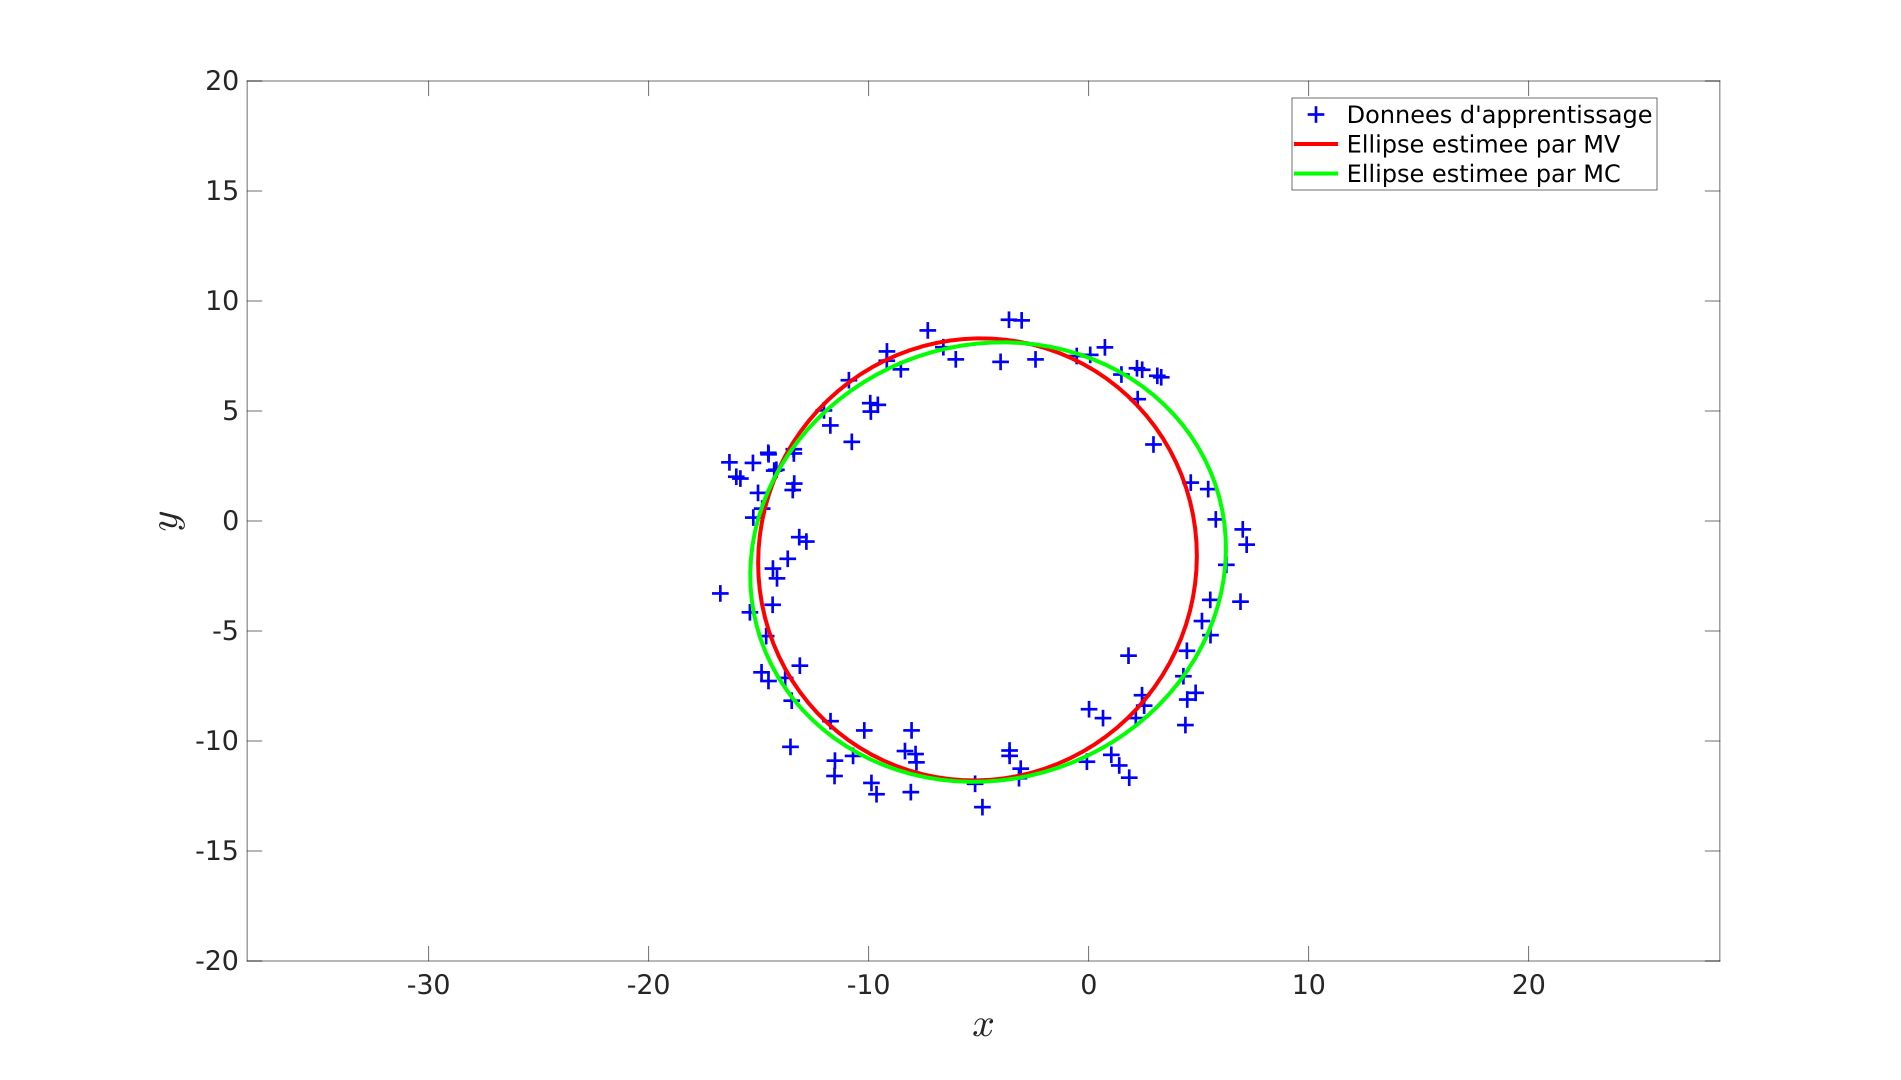 |
|---|---|
| Fig. 15 : Données | Fig. 16 : Estimation obtenue |
Avec les scores suivants :
Score de l'estimation par MV (Maximum de vraisemblance) : 0.948
Score de l'estimation par MC (Moindres carrés): 0.931
Il est assez difficile de se prononcer sur l'efficacité de cette méthode vis-à-vis de la précédente simplement à partir de ces images, mais statistiquement, et surtout après de nombreux tests, la méthode MC semble l'emporter en termes de précision.
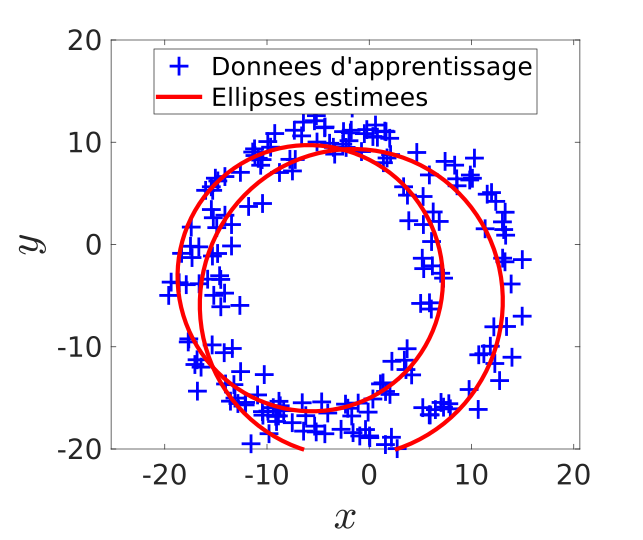
Le problème se complexifie ici nettement, avec l'introduction d'une nouvelle ellipse dans le dataset, grâce au script donnees_2, une nouvelle difficulté que la fonction max_vraisemblance_2 aborde en maximisant la log-vraisemblance :
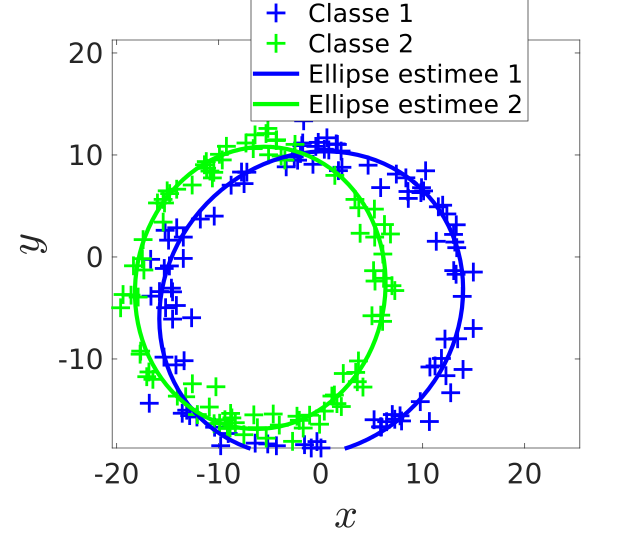
La fonction probabilites, elle, permet d'associer les points à l'ellipse la plus proche, et partitionne ainsi les points en deux classes et .
Les résultats obtenus sont les suivants :
 |
 |
|---|---|
| Fig. 18 : Maximum de vraisemblance | Fig. 19 : Moindres carrés |
Par la suite, on se propose d'améliorer grandement les performances de cet algorithme grace à l'espérance-minisation.
L’algorithme EM (Espérance-Maximisation) est un algorithme très général. Il s’inspire de cette idée, à ceci près qu’il n’effectue pas une partition stricte des données.
On a ainsi créé les fonctions probabilites_EM et moindres_carres_ponderes qui permettent d'appliquer cette méthode (cf. sujet pour détails concernant les calculs réalisés).
A terme, on obtient des scores plutôt impressionnants :
Score de l'estimation par MV : 0.785
Score de l'estimation par MC : 0.914
Score de l'estimation par EM : 0.977
avec l'algorithme EM loin en tête en termes de précision.
Le script exercice_4 ne parvient néanmoins pas toujours à trouver la bonne paire d'ellipses dans les situations où le résultat de l'estimation par MC, que l'on utilise comme point de départ, est trop éloigné de la réalité, et où les ellipses sont trop proches.
Cette partie s'intéresse à la segmentation d'images en niveau de gris par classification. Le principe est simple : on choisit N classes supposées gaussiennes, et l'on détermine la configuration maximisant la probabilité a posteriori de , en supposant les moyennes et les écarts-types des classes connus au préalable.
Dans un premier temps, on s'intéresse à une approche supervisée, qui consiste à déterminer les classes à partir de zones sélectionnées par l'utilisateur, et représentatives de chaque classe :
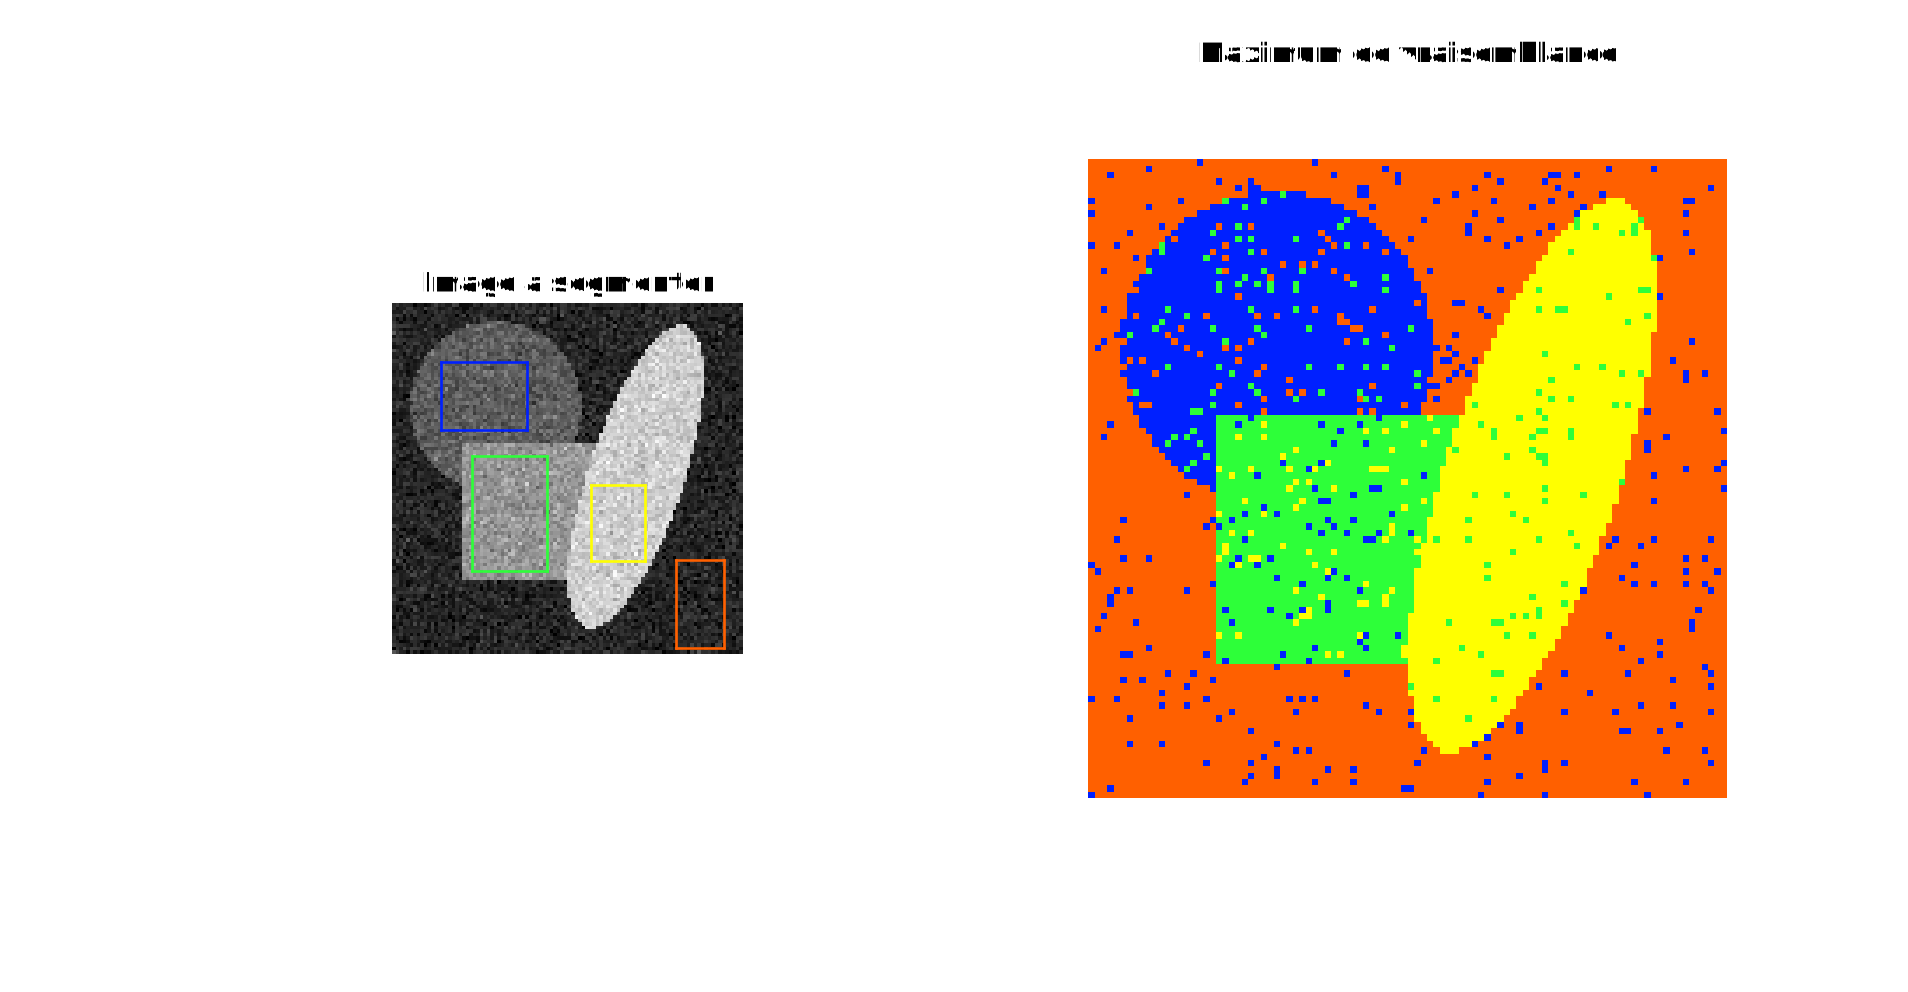
Comme on peut le constater, l'algorithme est très simple à implémenter, et ce comporte plutôt bien, si l'on fait abstraction de la présence d'un léger bruit sur l'image générée qui perturbe la classification.
Il est intéressant par ailleurs de tester des configurations moins optimales :
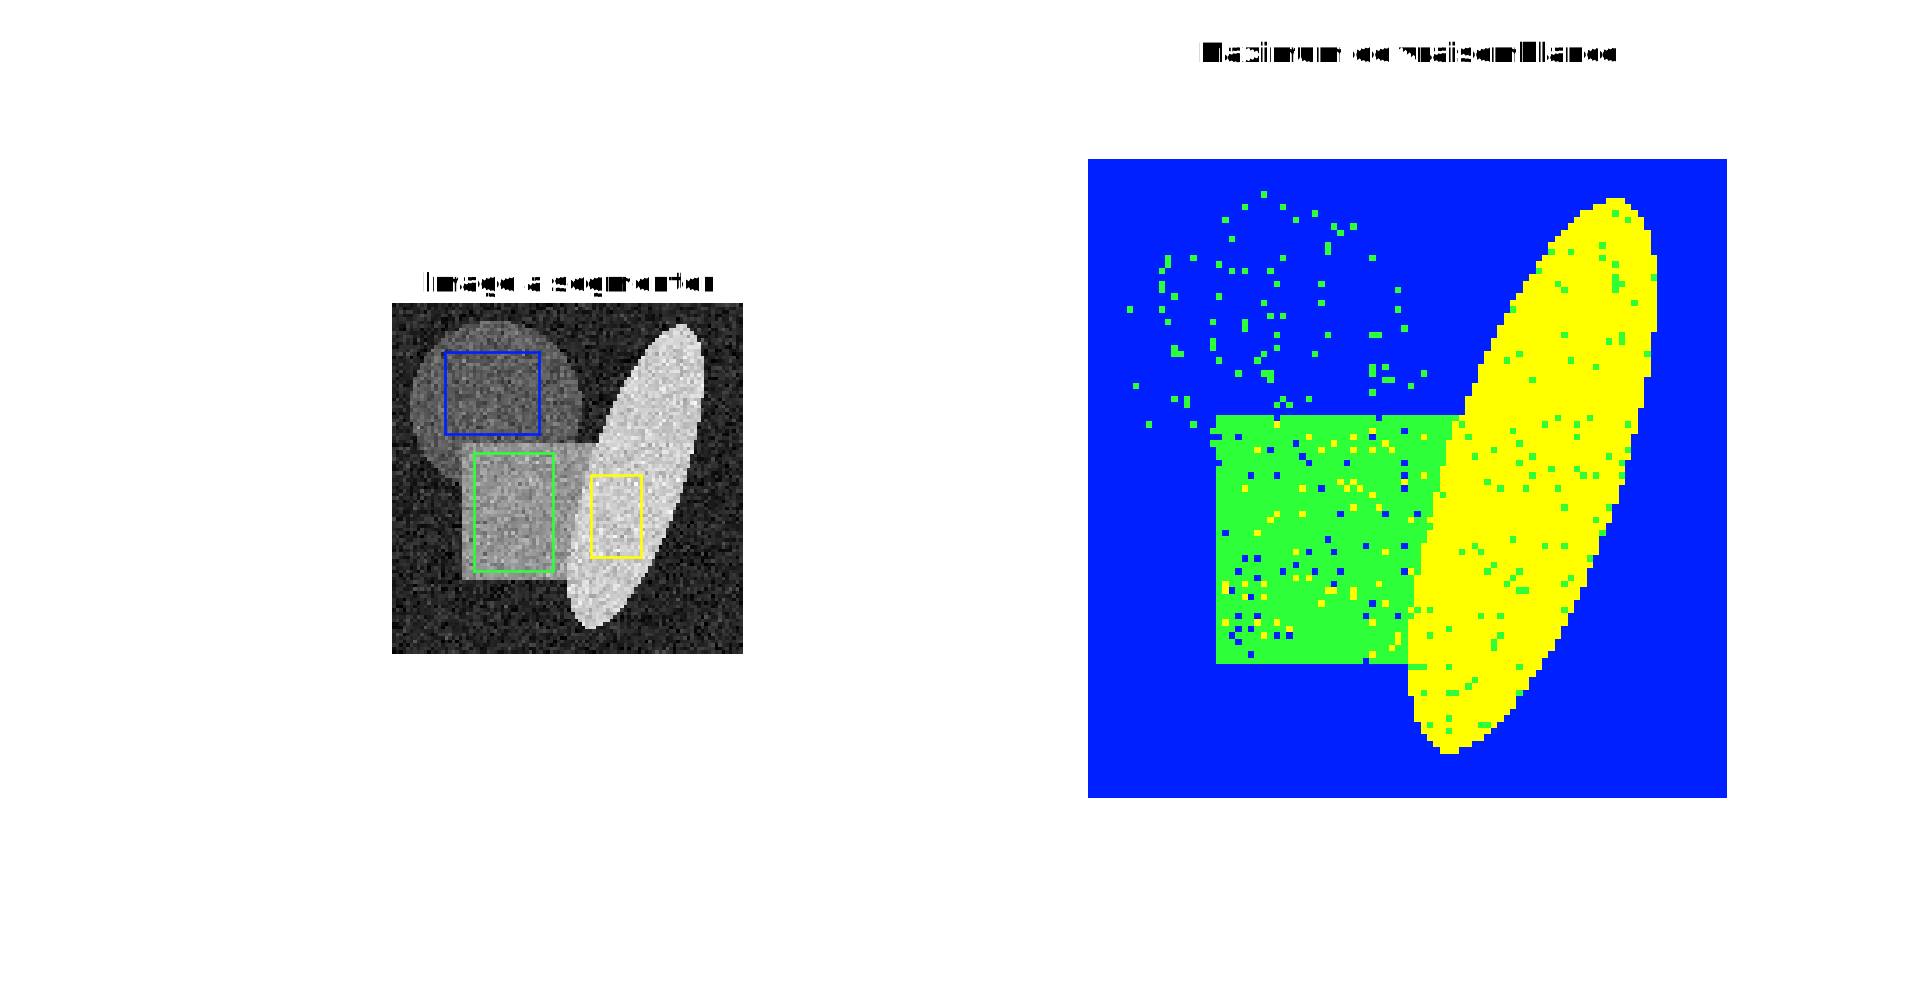
On constate ici que le cercle le plus sombre est catégorisé comme fond d'image en raison de sa proximité chromatique avec ce dernier.
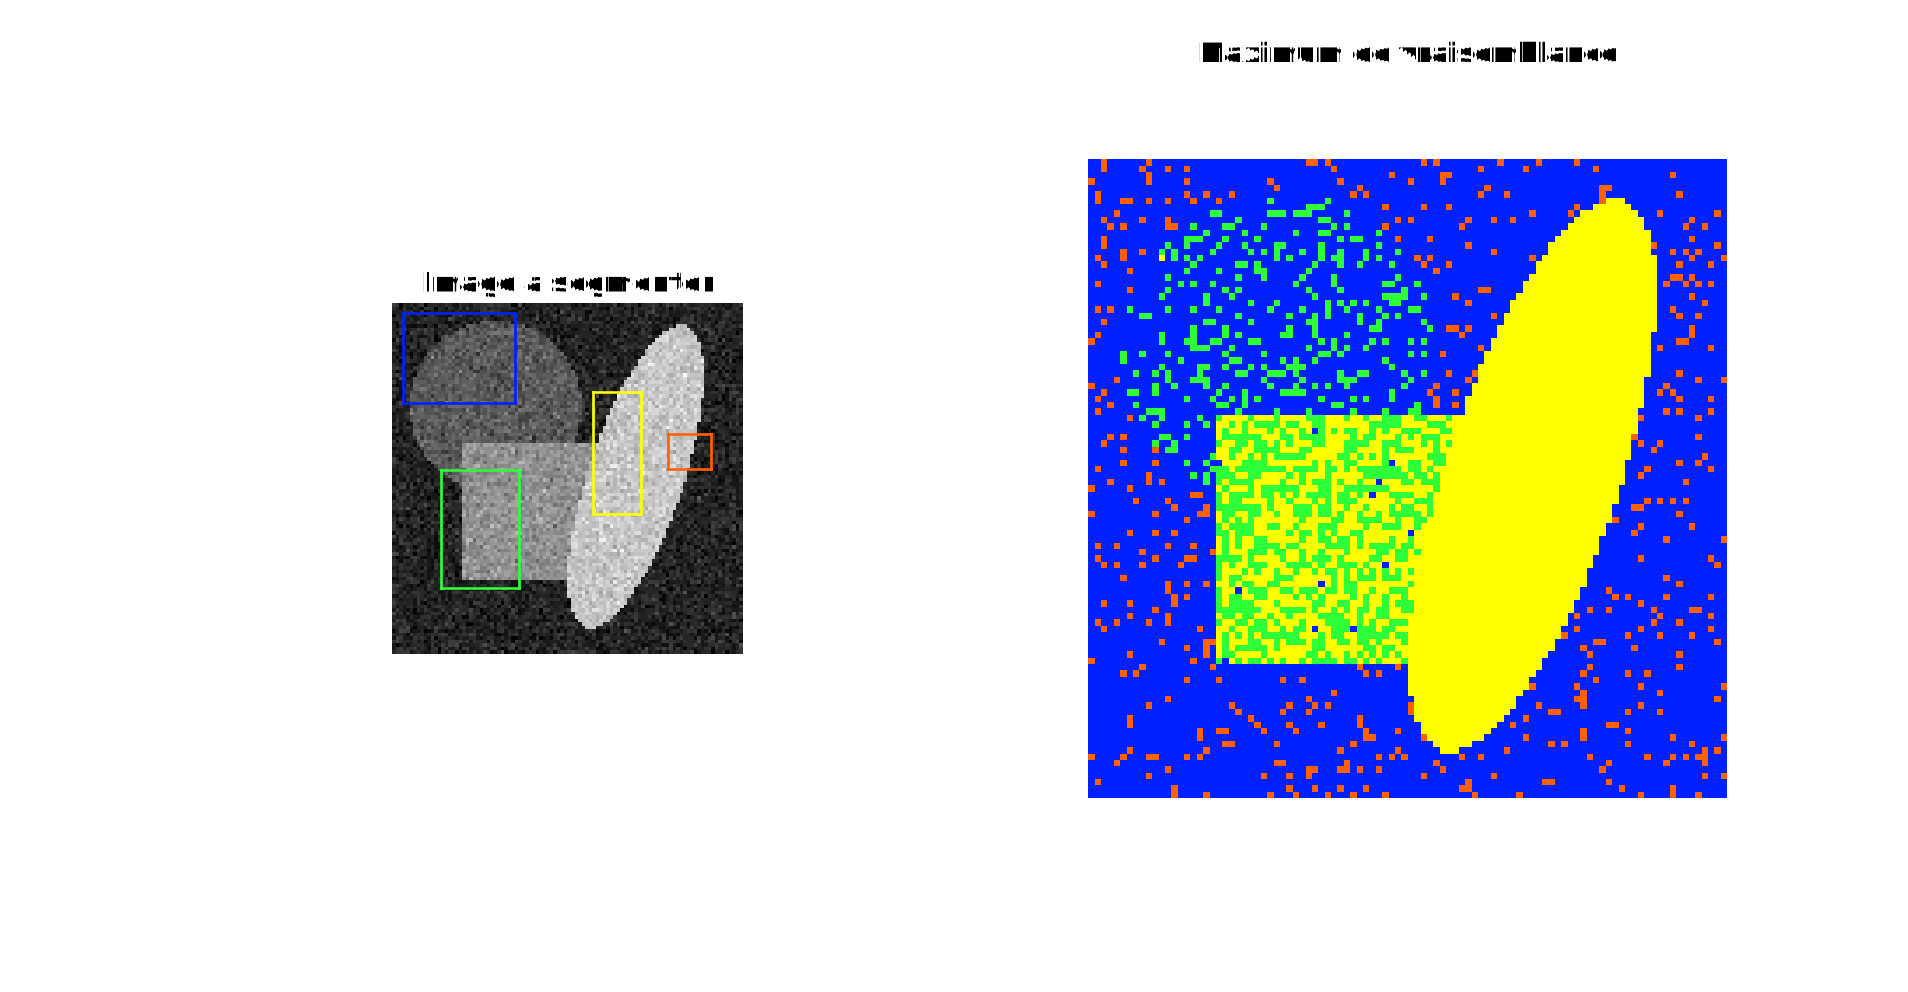
Il est clair que l'étape de sélection est cruciale pour obtenir des résultats satisfaisants. C'est pourquoi on a tout intérêt à se tourner vers une classification non supervisée, qui ne nécessite pas l'intervention d'un "expert" (en l'occurrence, l'utilisateur).
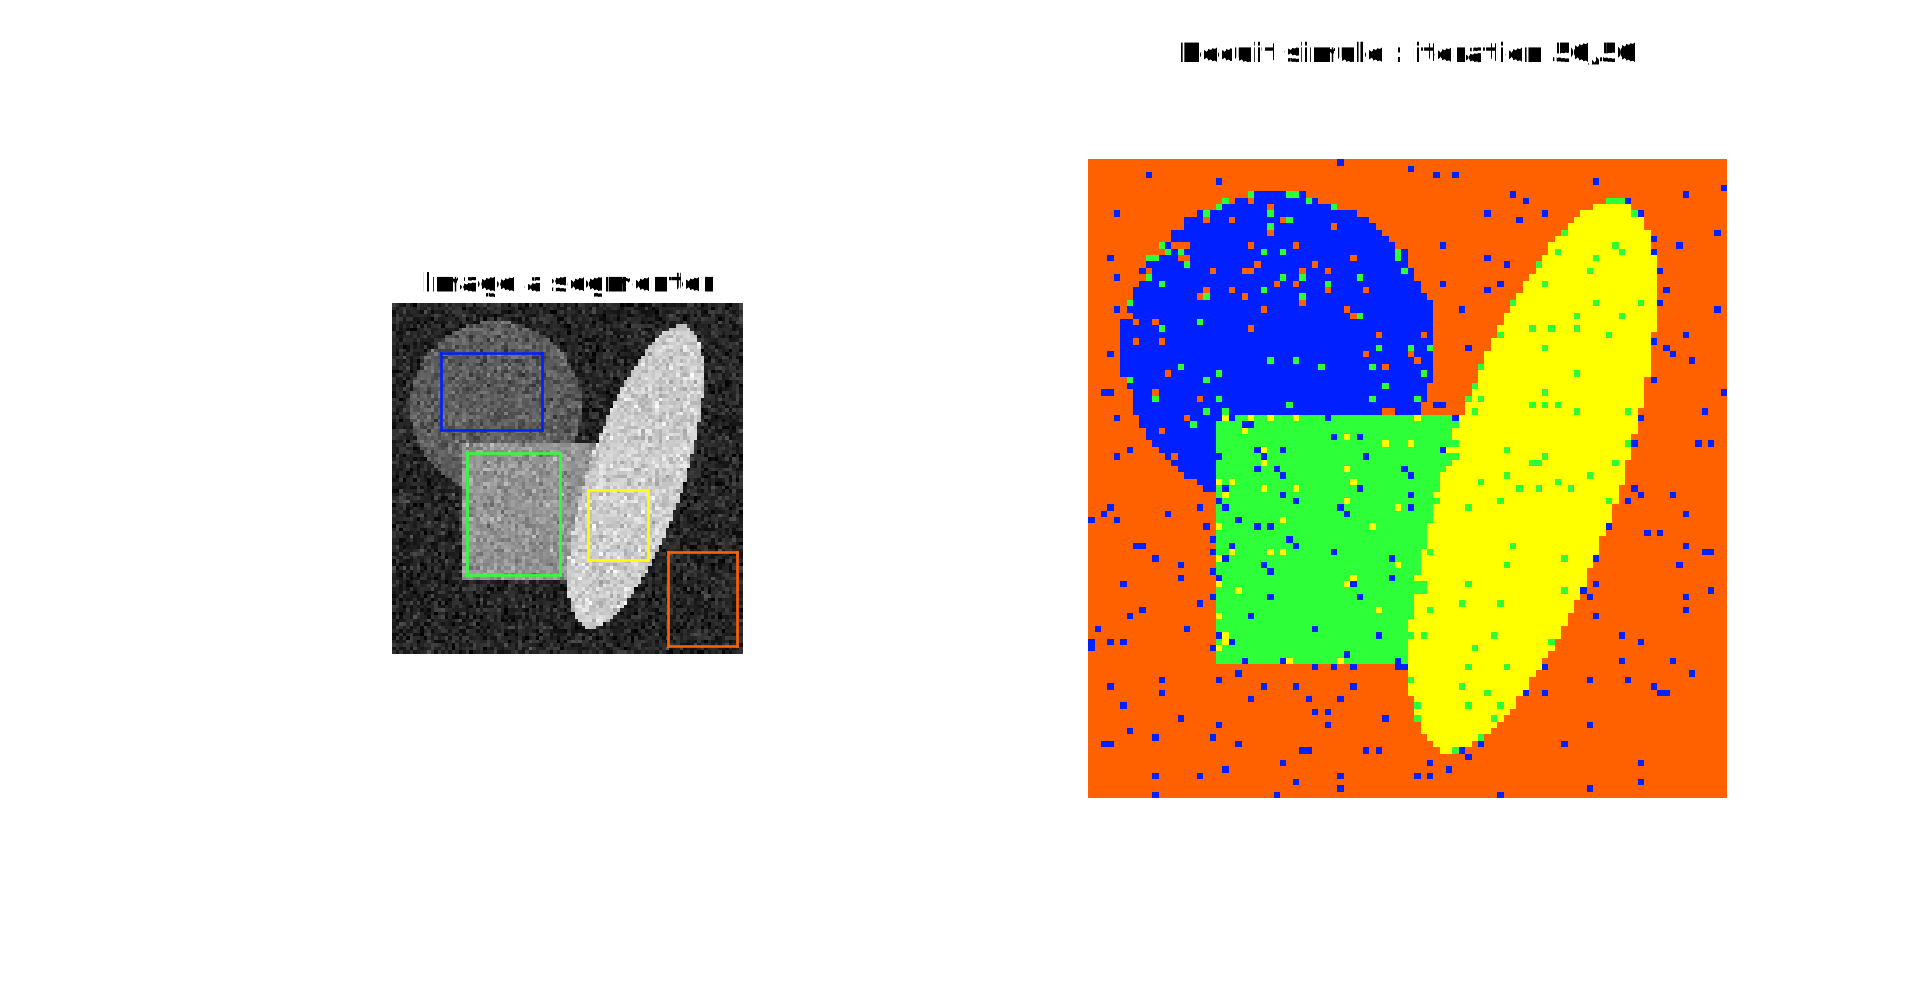
Note au lecteur: la fonction recuit_simule ne produisant pas de résultats convaincants, je n'ai pas jugé intéressant de la détailler ici. Néanmoins, voici le résultat après 50 itérations du recuit :
On a maintenant modifié le script exercice_1, afin qu'il appelle la fonction estimation_non_super qui permet d'identifier les classes par tirage aléatoires. Ainsi, on génère des paramètres et au hasard, et on choisit ceux qui minimisent l'argument du problème ci-dessous :
Les résultats sont très convaincants, et proches de ceux obtenus avec la classification supervisée, comme on peut le constater sur la figure suivante :
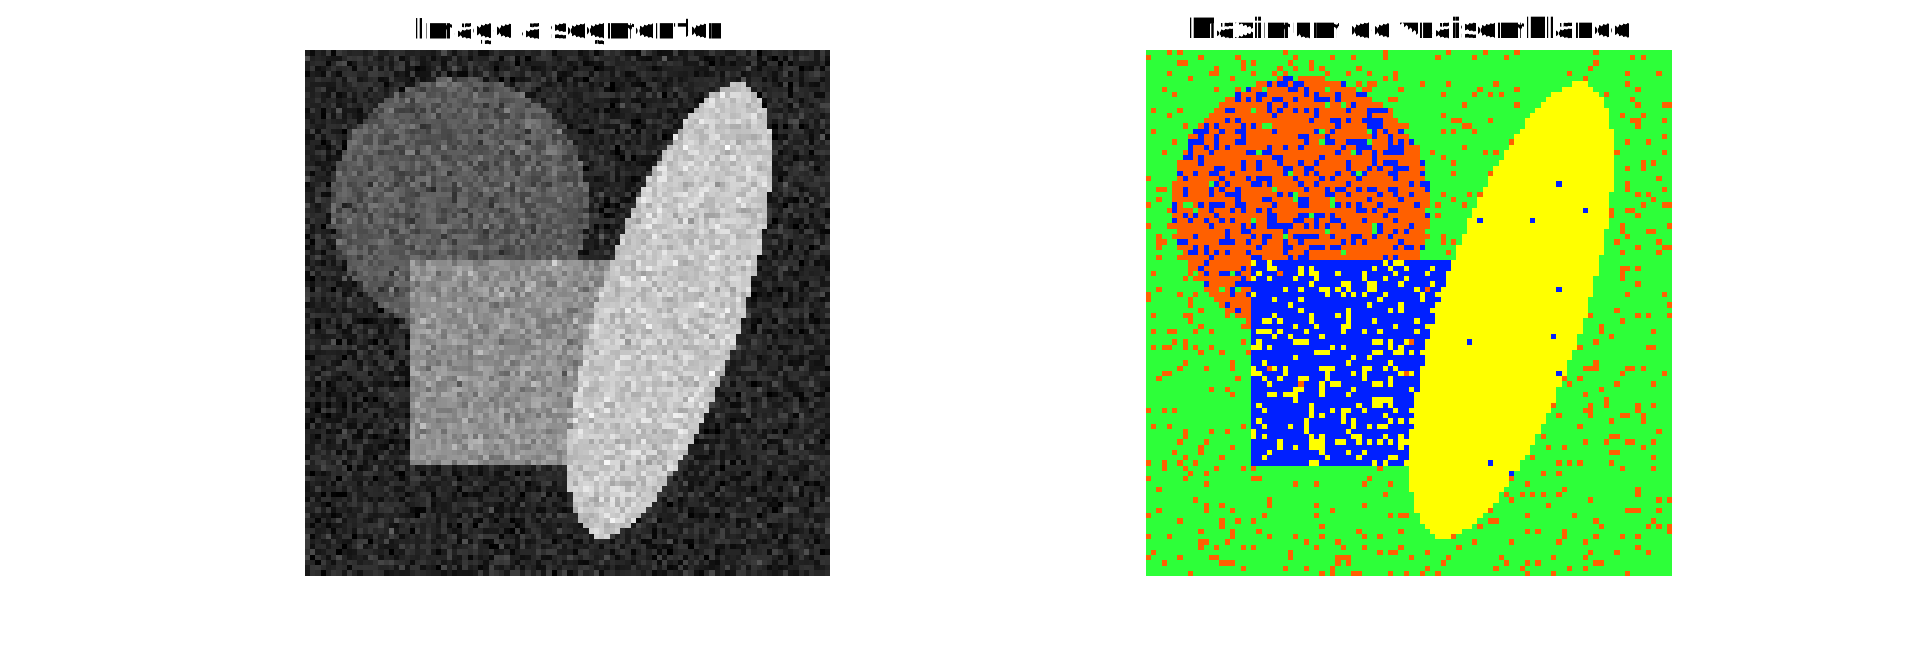
Le script signale en fin d'exécution un pourcentage de pixels correctement classés égal à 88.59%, ce qui est très proche des 92% obtenus précédemment avec la classification supervisée.
On aborde maintenant la détection et le comptage d'individus sur une image, en l'occurence des flamants. Le principe directeur de cette partie est assez simple : on place des disques sur l'image à analyser, et on les déplace de façon à ce que le niveau de gris moyen de la surface qu'ils couvrent soit maximal.
L'exécution du script exercice_0 nous permet de trouver une faille à la technique mentionnée précédemment, qui est la tendance naturelle des disques à ce regrouper en deux ou trois points très lumineux, en raison du fort niveau de gris en ces positions.
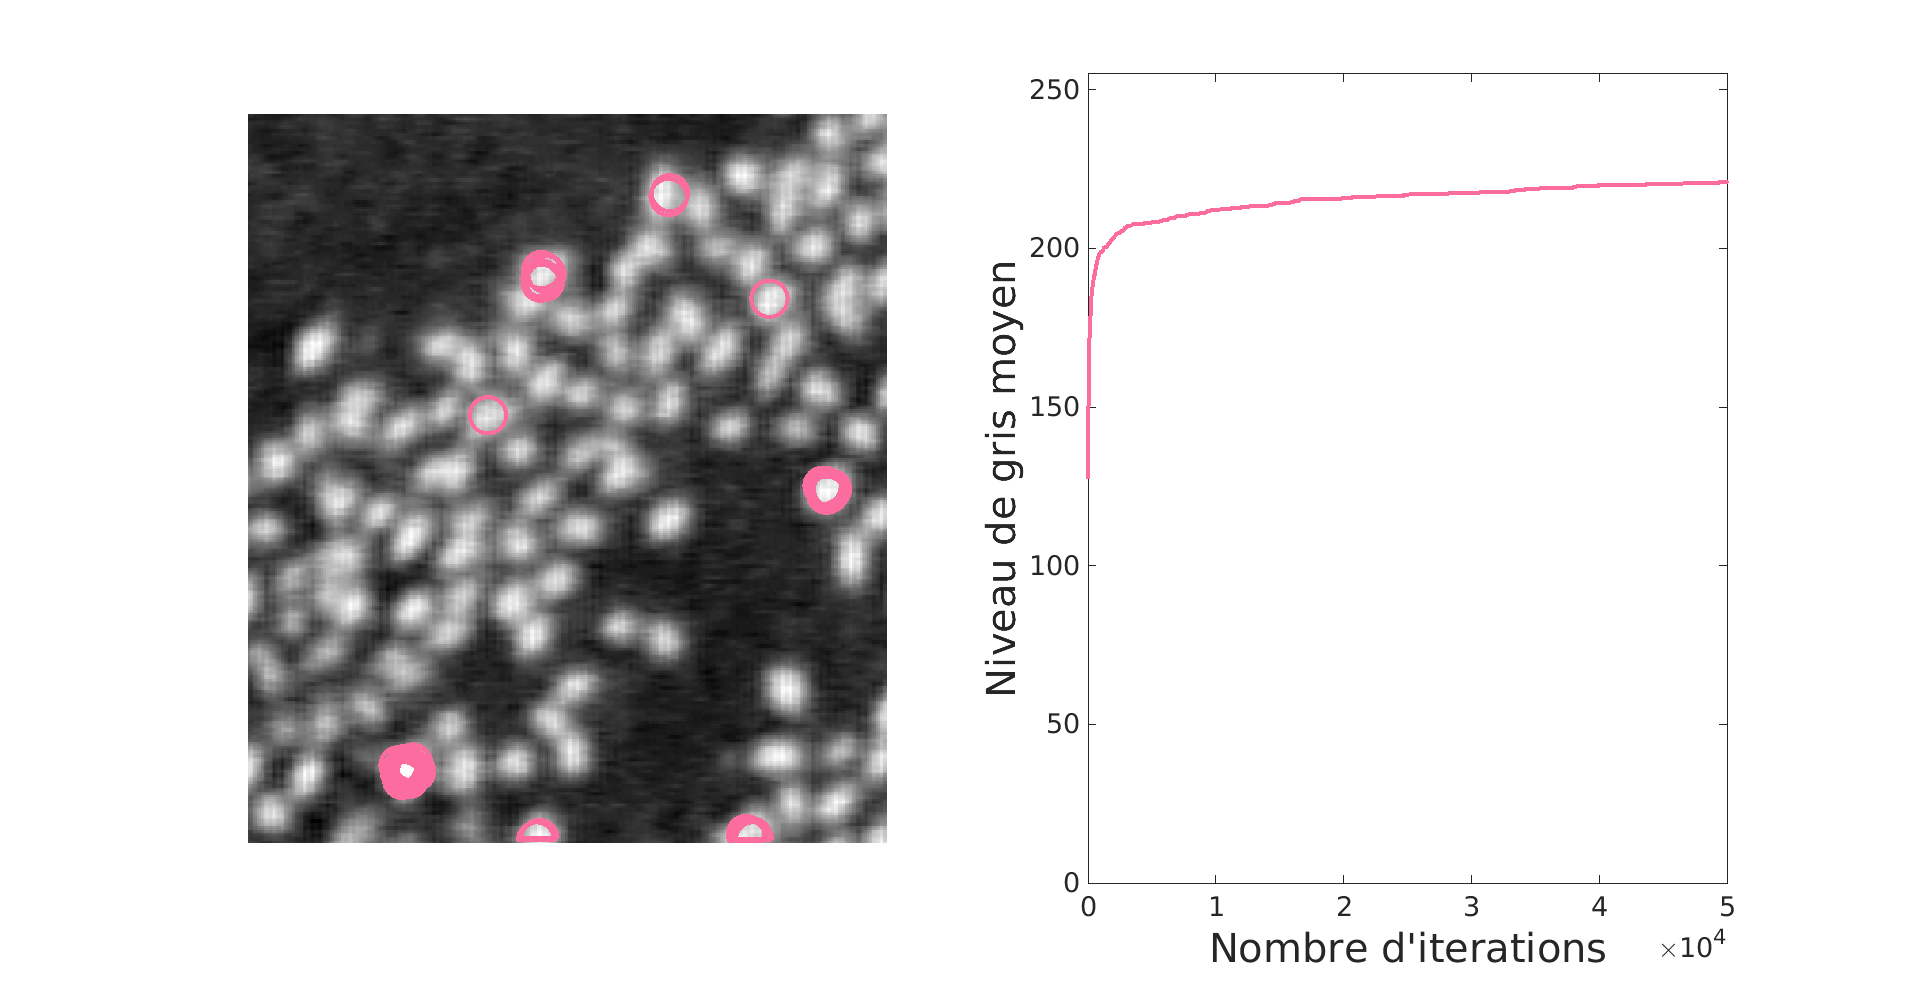
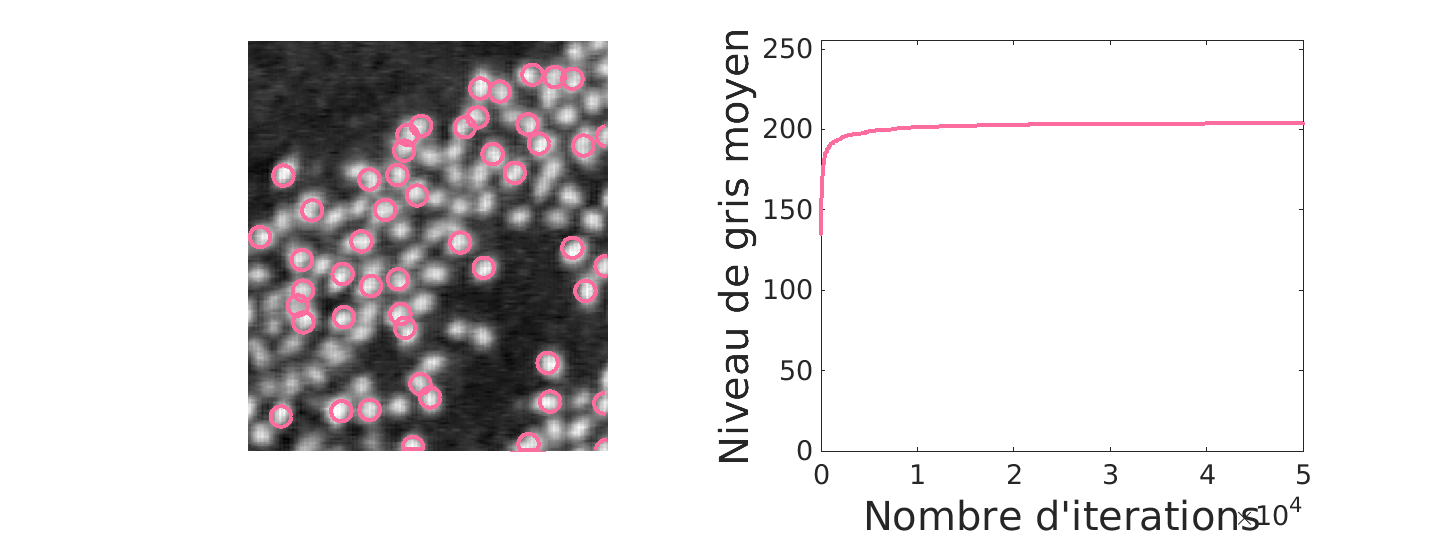
Dans le but de palier à ce problème, on introduit une énergie pour chaque disque, que l'on cherche à minimiser :
On constate alors une nette amélioration, puisque les disques sont "forcés" à rester éloignés de leurs voisins, comme on peut le constater sur la figure suivante :
On s'intéresse maintenant à une approche par processus ponctuel marqué, qui à la différence d'un champ de Markov, est un processus aléatoire dont la dimension temporelle est importante. Encore une fois, on cherche à minimiser l'énergie, dont la nouvelle expression est :
avec la fonction sigmoïde définie comme suit :
(cf. sujet pour plus de détails concernant les termes évoqués)
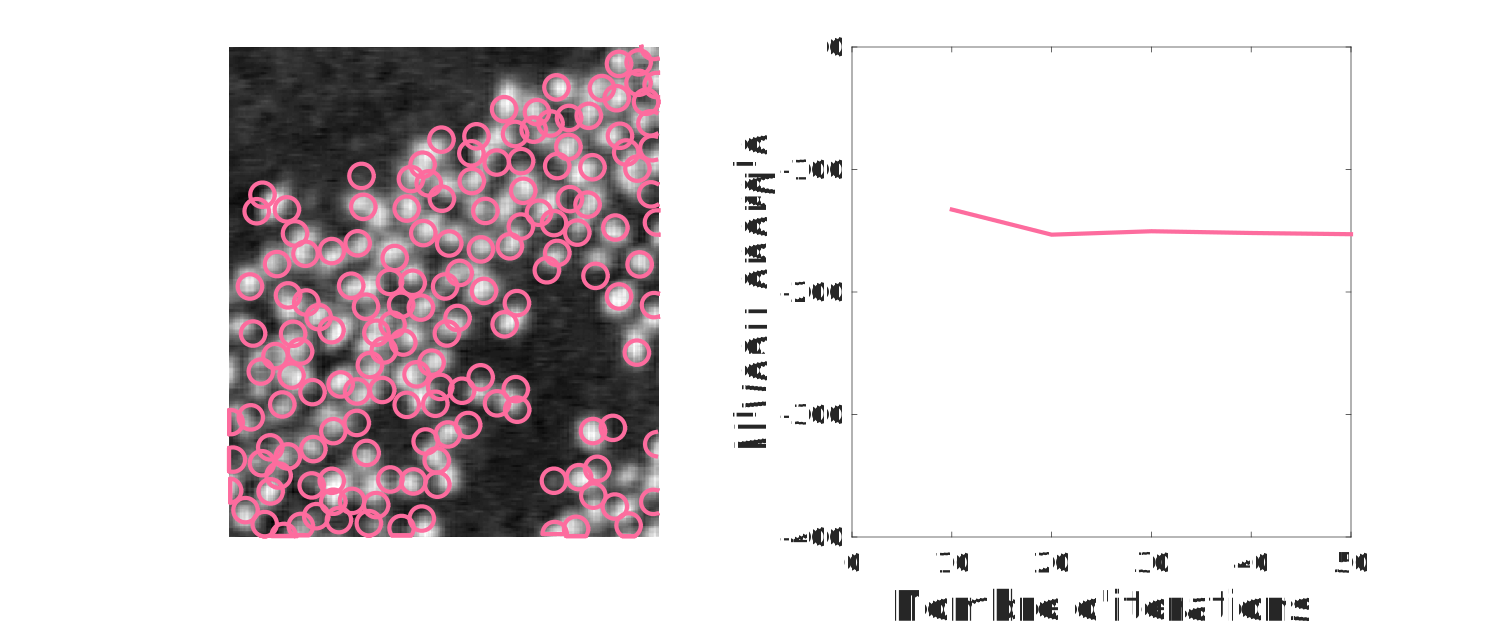
Le script exercice_2 que nous nous proposons de modifier, lui, applique l'algorithme d'optimisation par naissances/morts, dont nous avons détaillé les étapes ci-dessous :
stateDiagram-v2
  state "Naissances" as nais
  state "Tri des disques" as tri
  state "Morts" as mort
  state "Initialisation" as init
  state test <<choice>>
  state "Boucle" as loop
  state loop {
    [*] --> nais
    nais --> tri
    tri --> mort
    mort --> test
    test --> nais: pas de convergence
    test --> [*]: convergence
  }
  [*] --> init
  init --> loop
  loop --> [*]
Les résultats obtenus sont plutôt satisfaisants, et on peut constater que les disques sont bien placés, bien que certains d'entre-eux soient tout de même quelques-fois plus d'un par flamant. Ce problème peut être résolu en modifiant certains des paramètres de façon a contraindre un peu plus les disques à rester bien sur le flamant, tout en gardant leurs distances avec leurs voisins.
Cette étude a été très intéressante, et m'a permis d'aborder une multitude de problématiques du traitement d'image aussi passionnantes que variées. J'aurais aimé pouvoir y consacrer plus de temps, et faire notamment les parties facultatives des TP, mais le travail requis dans les autres matières ne m'a pas permis de le faire.